1037 Film / 视听语言
视听语言的本质
注:本文内容包含我强烈的个人观点,而这些观点并不是中立的。
读者阅读时请审慎采纳。
翻开市面上任何一本《视听语言》教材的目录,你会发现,它们的结构事高度趋同的。
一般是先讲画面(构图、光线、色彩、运动),再讲声音(人声、音乐、音响),最后讲剪辑(蒙太奇类型、连贯性剪辑、跳切)。
也就是所谓的视听语言三大构成要素——画面、声音、剪辑。
影视专业学生可以准确描述正反打镜头组的轴线关系、区分平行蒙太奇与交叉蒙太奇、列举声音的三要素。
但一个更基础的问题通常得不到回答——视听语言到底是什么。
它的本质到底是什么。
当我们翻阅完完麦茨、希翁、塔可夫斯基的著作之后,一个结论变得逐渐清晰起来。
整个影视教育体系对「视听语言」的理解,停在了将语法等同于语言、将零件清单等同于运作原理的位置。
教材的任务是教授操作,不需要回答本质问题。
但当「景别分类+蒙太奇类型+声音三要素」被默认为视听语言的全部,一个根本性的误解随之固化。
视听语言被等同于一套固定的技术编码系统。
它不是的。
同样的正反打对话场景,在侯孝贤的镜头下是漫长的凝视与留白,在诺兰的镜头下是信息密度的极限压缩。
同样一组镜头,不同导演拍出来,感知效果天差地别。
规则是相同的,结果完全不同。
这说明规则之外存在更底层的机制。
视听语言的根本不在可穷举的技术条目里。
视听语言的本质是图像与声音在时间维度上构建的一种复合感知契约。
观众坐在银幕前的每一秒,大脑在无意识地执行一项操作,即将此刻听到的声音与此刻看到的画面合并为同一事件的两个组成部分。这份契约显然不是天然的,不是生理性的,它是被一百余年电影史训练出来的感知模式。但它一旦建立,就从根本上改变了信息进入意识的路径。
这个定义需要逐层展开。
影视教育中存在一个根深蒂固的排序,先有画面,后有声音。
画面是「本体」,声音是「附加」。
电影史教材的叙事框架强化了这种排序——1895年卢米埃尔发明电影,1927年《爵士歌王》实现声画同步,中间有三十二年默片黄金期。画面在先,声音在后,看起来是天然的主次关系。
这个排序包含一个隐含的价值判断,画面是本体的、原生的、自足的;声音是后来的、附加的、可有可无的。这套叙事使电影人、评论人、观众和教材编写者本能地将声音置于次要位置。
法国声音理论家米歇尔·希翁在《视听:幻觉的构建》(1990)中用一个概念拆解了这个迷思:「视听契约」(audiovisual contract)。其核心论证是,声音和画面之间不存在天然的、生理性的联系。将一个声音与一幅画面并置,大脑会自动将它们「焊接」在一起,仿佛二者本来就属于同一个事件。
这种连接是感知系统主动制造了联系。
希翁为此创造了一个术语:synchresis(同步整合),由 synchronism 与 synthesis 合成。
其定义是:当一个声音事件与一个视觉事件同时发生,人脑产生自发的、不可抗拒的心理融合,完全不受理性逻辑控制。拳头打在脸上的声音是后期用西瓜碎裂声替代的,但在观影瞬间,观众感知到的是「那个拳头真的打到了」,从而认为这个画面产生了强烈的临场感。
于是感知系统在同步发生这一条信息上就完成了绑定,这样的画面因此不需要某种tell don't show的真实性担保。
这才是视听语言的底层操作系统。
景别语法和蒙太奇规则是应用层工具。
图像与声音之间的绑定关系是人为建构的,但人脑一旦接受这种建构,它就变得比物理真实更真实。
希翁的另一个核心概念是「增值」(added value)。
声音赋予影像的表现性和信息性价值,会使观众产生一种错觉——认为那些信息或情绪「自然地」来自画面本身,实际上它们完全由声音建构。
《2001太空漫游》中 HAL 9000 的声音是一个精确的案例。
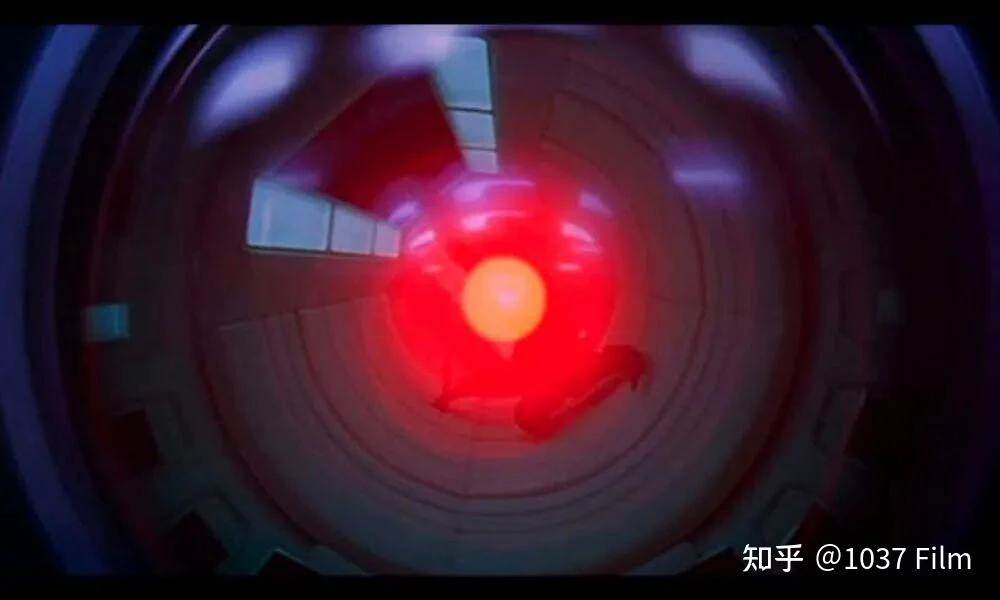
库布里克没有给 HAL 一个金属感、电子化、断续的「机器人声音」,而是赋予它一个比人类更平静、更柔和的男声。
结果HAL 成为整部电影中最令人毛骨悚然的存在。
那个声音越温柔,恐惧越强。
这份恐惧并不来自画面,将 HAL 的台词字幕打在黑屏上,不会产生同等效果;将 HAL 的红色摄像头画面配上轻松的背景音乐,也不会。恐惧是由声音与画面的特定组合制造的。而恐惧一旦产生,观众就会认为「HAL 本来就很恐怖」,在意识层面上观众无法分辨情绪是声音植入的。
这就是增值机制。
声音建构了感知,感知却被归因于画面。
所以一部电影的混音的重要性,远比我们认为的还要大。
这一理论对传统「画面为本」的视听语言教学框架构成了根本性挑战。如果声音可以凭空建构观众对画面的感知,那么「先有画面后有声音」的排序就失去了基础。
视听语言不是画面语法加声音调料,而是画面与声音在时间流中持续的、不可逆的、相互吞噬又相互生成的过程。
塔可夫斯基在《雕刻时光》中提出了一个被广泛引用但很少被严格对待的命题:「电影的本质是时间。」
关键不在于「电影记录时间」,而在于「电影用时间雕刻而成」。
时间不是电影的素材之一,时间是电影的唯一素材。
这一观点对视听语言=编码规则的认知体系构成了更深层的冲击。
如果电影的本质是时间——而非画面、叙事或表演——那么视听语言的根本功能不是「清晰地传达故事信息」,不是「制造视觉美感」,不是「引导观众注意力」。
这些是次级功能,首要功能是,在时间维度上组织观众的感知体验。
塔可夫斯基在《索拉里斯》(1972)和《潜行者》(1979)中反复验证了一个原则,声音可以不跟随画面。声音可以跑在画面前面,也可以落在画面后面;可以预告画面将要去的地方,也可以将画面拽回已经过去的时间层。
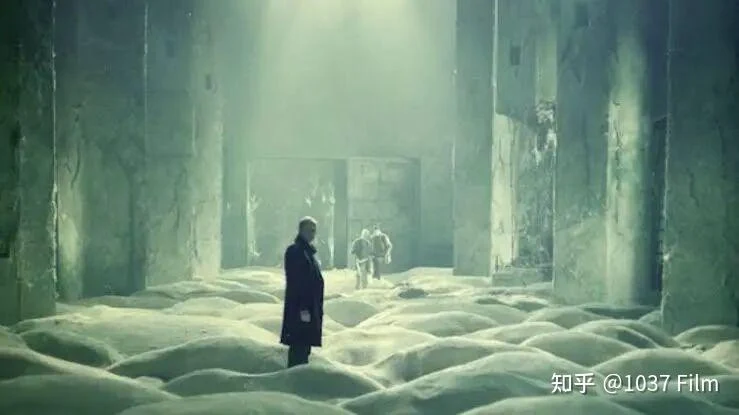
在《潜行者》中有一段大约五分钟的轨道车旅程——主角三人乘坐手动轨道车驶入「区」。
画面几乎不变:三人的面部、轨道车的机械运动、灰蒙蒙的远景。声音设计师爱德华·阿尔特米耶夫使用 Synthi 100 合成器执行了一个精确的时间方案:让声音每隔约十秒发生一次变化——轮轨的原始噪音加入人工混响,替换为人造低频震颤,叠入管风琴式的暗涌,最后铺入近乎阈下感知的男声合唱。
在这一过程中,现实被声音逐步替换为另一种东西。
画面中未出现任何超自然元素,但观众听到了世界底层在扭曲。
这验证了希翁的论断,声音比眼睛更快。听觉处理速度远快于视觉。声音在观众意识到画面内容之前就改变了感知状态。《潜行者》那五分钟轨道车戏没有使用一个特效镜头,没有一句台词解释进入了超自然区域。
塔可夫斯基只做了一件事,让声音走在画面前面,逐帧替换「现实」。
大多数影视教材将「声画关系」归纳为三种类型:声画同步、声画对位、声画分离。
讲完这三种,配上两个例子,这一章就结束了。
但塔可夫斯基的实践表明,声画关系不是三种类型可以穷举的。
声画关系是一个时间函数——声音相对于画面的提前量、延迟量、融合度、分离度,在时间轴上每一帧都在变化。
用「声画对位」四个字概括《潜行者》轨道车那五分钟,相当于用「有对白有音乐」概括瓦格纳的歌剧。语法分类在这里是失效的。
塔可夫斯基在《雕刻时光》中还提出了一个常被忽略的观点:「这世界上的声音本身就够美了——如果学会真正去听,电影根本就不需要音乐。」
他不是反对音乐,而是反对「用音乐给画面贴情绪标签」的懒惰操作。
导演的工作不是挑选合适的配乐覆盖画面,而是创造一种声场,让声音和画面在时间中产生化学反应。
他称之为「声音和噪音的组织」,而非「配乐」。
这个区分至关重要。
配乐思维的操作逻辑是,画面有一个情感目标(悲伤),我要配一首符合该目标的音乐(大提琴慢板),然后观众接收情感信号(悲伤),好了任务完成。
塔可夫斯基的声音组织逻辑是,我要创造一种声音环境,让观众在该环境中自行生成情感——情感不是被音乐告知的,而是被声音与画面在时间中的互动催生的。
视听语言的本质,在塔可夫斯基这里,已从「编码-解码」模型转变为「环境-生长」模型。
观众不是在读一个文本,而是在一个时间容器中经历一场感知事件。
塔可夫斯基回答的是「视听语言如何在时间中运作」,麦茨回答的是另一个更基础的问题——「视听语言到底是不是一种语言」。
这个问题直接决定了理解电影的理论框架。
麦茨在1964年发表的《电影:纯语言还是泛语言》奠定了电影符号学的基石。
结论是:电影不是一种「语言」(langue),而是一种「泛语言」(langage)。
区别在于结构语言学中的「双层分节」——真正的语言(如中文、法语)中,最小意义单位(语素)由更小的无意义单位(音素)组成。
电影没有这个双层结构。
一个镜头就是一个完整的陈述:特写一把左轮手枪,这个画面不意味着「左轮手枪」这个词,它意味着「这里有一把左轮手枪」。
镜头是句子,不是词语。
这个论证的推论是,视听语言永远不可能被「翻译」成文字而不损失其本质。
我们可以用文字描述一个镜头的内容——「一个男人走向地平线」——但无法传达该镜头在时间中的重量。那个男人走了多久?背景里有什么声音?光线如何变化?镜头是静止跟随还是缓缓推近?所有这些「不可翻译」的部分,恰恰是视听语言的本质所在。
麦茨的另一个洞见也很有意思,他认为电影之所以具有跨文化普遍性,不是因为图像是普世语言。恰恰相反——图像的含义高度依赖文化语境(红色在不同文化中意味完全不同)。
电影之所以「普遍」,是因为视觉感知的生理差异远小于民族语言之间的文化差异。
一个中国观众和一个法国观众看同一部电影,它们「理解」的方式固然可以不同,但「感知」的方式却一定是高度接近。电影跨过语言的巴别塔,不是通过图像普世语法,而是通过感知通路的直接性。
麦茨之后,电影符号学经历了三个阶段。
首先是符码研究(分类表意元素),然后过渡到文本研究(分析深层意识形态),最后派生为主体研究(引入精神分析考察观众认同机制)。
这个过程本身是一种暗示,「视听语言」这个对象无法在单一层面上穷尽。
讨论「视听语言的本质」,不可避免地要同时处理它的表意系统、文化运作机制以及它作用于观众无意识的方式。
三者缺一不可。
但常见的教材的处理方式是将「麦茨」放在电影理论史的一章中,讲完八大组合段,下一章进入轴线规则。学生学会用「平行蒙太奇」「交叉蒙太奇」「重复蒙太奇」做拉片分析也就够了。
但麦茨揭示的底层问题被遮蔽了,视听语言的根本限制恰恰是它的本质——它不是一套可以被穷举的编码系统。
1928年8月,爱森斯坦、普多夫金、亚历山德罗夫联合发表《有声电影的未来》声明。
这份不到两千字的文件是电影理论史上最重要的文献之一。
三位苏联蒙太奇大师的论述是精准的。
声音是「一项有利有弊的发明」,最大危险是它会沦为「满足好奇心的」简单对白片。他们担心的不是技术本身,而是使用方式——如果将声音仅仅作为画面的同步附属品,蒙太奇的全部美学成果将毁于一旦。「声音必须与视觉形象形成管弦乐式的对位法」,在冲突和对立中创造新的意义,而非简单复制画面已说出的内容。
同期,卓别林的态度更为彻底。
1931年他在《城市之光》的宣言中写道:「对白片会毁坏世界上最古老的艺术——哑剧艺术。它消除了无声片的巨大美感。」他坚持自己的银幕角色「不是一个真实的人,而是一个幽默的思想,一个喜剧性的抽象品」,声音会摧毁这种抽象。
如今回看这些言论,容易将其归为大师的保守。毕竟观众用脚投票,于是我们看到1928年底好莱坞几乎全部转制有声片,默片时代的喜剧大师除卓别林外几乎全部被市场淘汰。
但事实是:爱森斯坦们的担忧,在将近一百年后,以一种他们无法预见的方式,正在成为现实。
他们担心的是「对白太多」。
现在的问题不是对白太多,是声音太多。
杜比全景声(Dolby Atmos)于2012年发布,支持最多128个独立音轨和64个独立扬声器,声音可作为独立的音频对象在三维空间中任意定位和移动。头顶、脚下、身后、身前——环绕精度可达到毫厘级别。这是声学工程上的革命性进步。
但技术能力与美学判断之间存在落差。
当我们可以在三维空间中精确控制每一个声音对象,「不让观众听到什么」反而失去了理由。结果是大量商业电影的声音设计走向声音饱和——每一个空间坐标被填满,每一个转场塞足氛围音效,每一个动作配以对应的声效组合。声场是满的,寂静被消除了。
日本经典动漫《死神》中,主角黑崎一护和反派蓝染的最后一战,黑崎一护使用了绝招「最后的月牙天冲」。在这一招放出的同时,背景音乐也像是被这一招一起斩断了一样而停止。事实上,所有这个片段的音效都因为这一招的使用而全部停止。
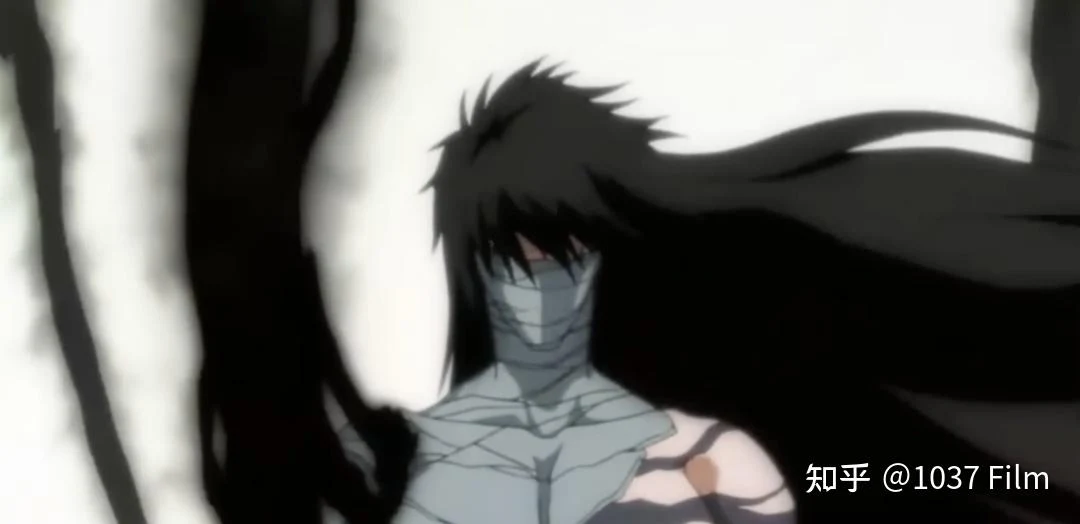
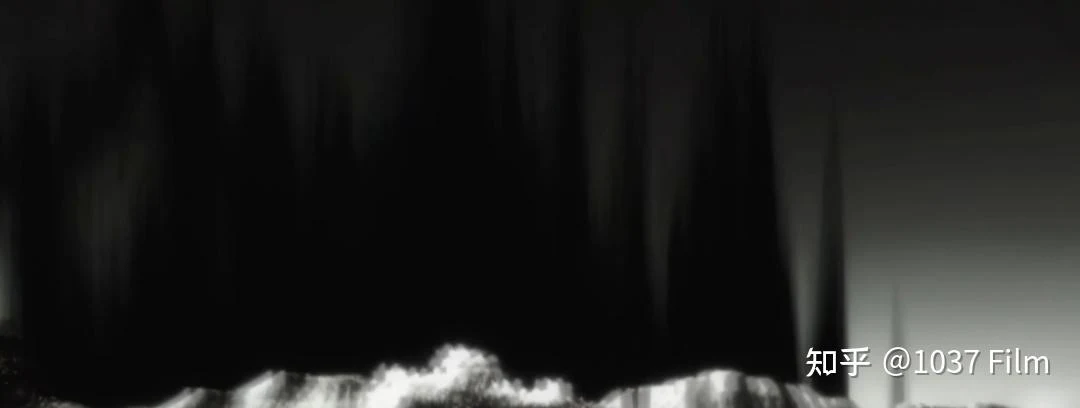
这是极为出色的一种展示。
说回全景声,全景声本身是中性技术。
但它暴露了一个深层问题。技术进步常常掩盖了艺术判断的贫乏。在塔可夫斯基的时代,技术限制迫使导演做出艰难的取舍——何时用音乐,何时只用自然声,何时静默。技术限制消失后,不做的勇气也随之消退。有音轨可加,于是加了;有128个通道,于是塞满了。
《地心引力》(2013)的声音设计师 Glenn Freemantle 在杜比官方访谈中描述过他的方法论:太空中声音不能通过空气传播,因此设计原则是「震动替代空气传导」——宇航员触碰舱壁时的低沉震颤、太空碎片撞击时的冲击波,所有声音都有物理依据。
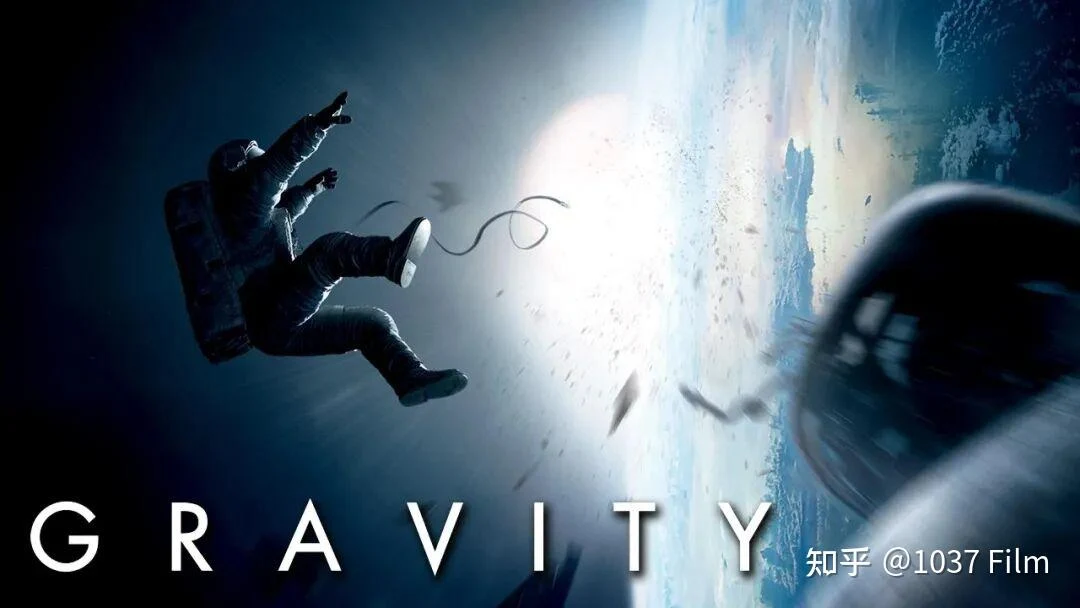
《地心引力》的声音设计之所以成立,不是因为技术,是因为判断。
但这一级别的判断在当下的电影工业中是稀缺品。
大多数商业大片的声音混音呈现同样的模式,低频轰鸣持续饱和,环境声从不中断,配乐几乎覆盖全程。声场没有呼吸,没有留白,没有那种什么都没发生但感知系统已检测到异常的时刻。
希翁在讨论「空间磁化」(spatial magnetization)时指出,影像有一种倾向,会将声音吸附到自己身上。我们看到银幕上有人,听到的声音就会自动被感知为「来自那个人」。这种吸附效应极强,观众的大脑会自行完成空间映射。杜比全景声的精确空间定位在多大程度上是观众真正需要的,在多大程度上是技术能实现于是便实现了——这是一个美学判断,不是技术问题。
希翁的理论体系中有一个关键概念——幻听者(acousmètre,由 acousmatic 与 être 合成)。指涉的是这样一种声音存在——能被听到,但声源不可见。它可能在画外,也可能在画面内但被刻意遮蔽。一旦声音失去了可见的「身体」,它就获得了一种特殊属性——无处不在、无所不知、不可抗拒。
电影史上每一个经典的幻听者案例都验证了这一机制。
库布里克的 HAL 9000——仅有一个红色镜头灯和一个声音,没有面部,却成为科幻电影史上最具压迫性的反派。
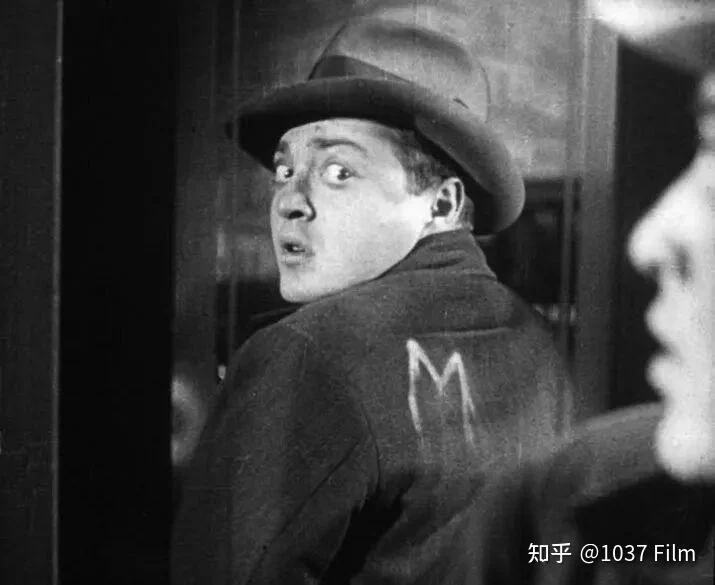
《M就是凶手》(1931)中只闻其哨声的连环杀手——观众在银幕上未见其面容,哨声本身即构成威胁信号。
《绿野仙踪》(1939)中的巫师——巨大的咆哮面孔投射在幕布上,声音震耳欲聋,直到小狗托托拉开帘子,露出后面瘦小的老人在操纵一切。帘子拉开的瞬间,巫师的权力随之瓦解。
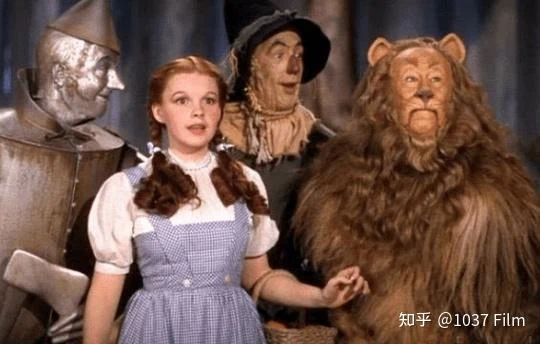
希翁将此称为「去幻听化」——一旦声源的身体被暴露,声音的神秘权力即刻消失。
这一机制在日常生活中有对应的心理模式。
在隔壁房间听到两个同事低声交谈但听不清内容时,焦虑程度远高于走过去站在他们面前听同样的话。信息来源的可视性决定信息的控制感,控制感决定情绪反应。
视听语言操控观众的核心技术之一,是对幻听状态的精确控制——什么时候让观众看到声源,什么时候不看到;什么时候先听到再看到(希区柯克式悬疑),什么时候先看到再听到(揭示式冲击)。
这一机制也解释了恐怖片声音设计比画面更有效的原理。画面提供确定的威胁(怪物长什么样是已知的),声音提供的是不确定的在场(声源位置不确定,距离不确定,强度变化不确定)。确定性安抚大脑,不确定性持续激活杏仁核。声音在进化上比图像更古老——人类的祖先在能看清黑暗中有什么之前,就能听到黑暗中有什么。听觉是原始的警戒系统,视觉是后来的分析工具。视听语言操控情绪的底层逻辑是:先经过听觉的警戒过滤,再经过视觉的认知确认。顺序决定效果。
但教材的声音章节讲的是「人声、音乐、音响」的分类学,而非「幻听-去幻听」的动力学。
分类学描述「它是什么」,动力学解释「它如何运作」。
视听语言的本质在动力学里,不在分类学里。
让我们再回到核心命题——视听语言的本质是图像与声音在时间维度上构建的复合感知契约。
这份契约具有四重属性。
第一,强制性。
观众进入电影院,灯光熄灭,无法选择只接收视觉信号而不接收听觉信号。声音会绕开意识直接作用于神经系统——你可以闭上眼睛不看,但很难关闭听觉(电影院中音量不受个体控制)。视听契约不是平等合约,声音在生理层面上比画面更具侵入性。
第二,动态性。
契约不是一次签署便永久生效。观影过程中每一秒都在更新契约条款。一个声音出现时观众不知道它来自画面内还是画面外,大脑在那一瞬间执行的是「悬置判断」——声源位置不确定,信息不完整,等待补充。这种悬置状态本身就是观影快感的结构性来源之一。惊悚片和悬疑片的核心张力机制,就是不断制造和延迟解决契约条款的不确定性。
第三,文化训练产物,而非天然。
一个从未看过电影的人,第一次面对银幕时的视听整合方式,与观看了一万部电影的人不同。
这一点可以参考克拉考尔在《物质现实的复原》中提到的“看见一只鸡”(The Chicken Anecdote)。
克拉考尔在书中描述了一位电影导演的实验报告:导演拍摄了一段5分钟的短片,展现西方大都市的高楼大厦、霓虹酒吧和繁华街景。导演将这部短片放映给从未见过现代城市、也从未接触过电影媒介的非洲原始部落原住民观看。观影结束后,原住民完全无视了导演精心构图的现代建筑与都市男女,反而异常热烈地讨论起“一只在泥沼里啄食的鸡”。
导演本人在拍摄和剪辑时完全没注意到这只鸡。他不得不回去逐格(frame-by-frame)检查胶片,才在画面的一个偏僻角落里,找到了这只出现不到1秒(仅8个画格)的鸡。
克拉考尔借由这个故事,精准地阐明了“从未看过电影的人”与“阅片万部的人”在面对银幕时,视听整合机制的根本差异:我们的大脑已被电影语言(如蒙太奇、景深、焦点、镜头推拉)所格式化。我们会自动跟随导演的叙事焦点,把角落里的杂物(如那只鸡)当作“环境噪音”过滤掉。我们看电影是在进行“思想与符号”的解码,整合出“城市、现代化、繁华”的抽象概念。
而从未看过电影的人,他们不具备任何“电影素养”,银幕对他们而言并非一个有主次秩序的虚构故事,而是一片未知的、等同于日常生活的物理现实光影。他们的视听整合无法与“高楼、霓虹”产生心理认同。他们会用最本能的、基于真实生存经验的框架,去搜寻画面中唯一熟悉且客观存在的物质符号——那只普通的鸡。
克拉考尔得出结论,电影手段之所以能够“救赎”物质现实,正是因为它能打破现代文明人因“习惯和偏见”在脑中设下的盲点。阅片无数的现代人,视听整合往往是被“观念”绑架的;而从未看过电影的原始部族,其视听反而在无意识中直奔未经现代工业文明掩盖的、最细微的物质底层。
视听契约被观影史迭代训练——观看数量、类型分布、消费模式(被动/分析),所有这些经验都在重塑契约的签署方式。这也是不同文化背景的观众对同一部电影反应可能完全不同的原因:不是「理解」不同,而是感知系统被训练成了不同的契约模式。
第四,在数字时代,这份契约正在被重新谈判。
契约不再仅在电影院中签署。手机竖屏刷短视频时,声音被压缩为单声道,画面被裁剪为9:16——这属于同一种「视听语言」吗?抖音上画面配以一段无关音乐,因算法推荐而并置,synchresis 正在被算法大规模制造。地铁上戴降噪耳机观看流媒体,空间音频被压入双耳但算法模拟环绕声——大脑在签署一份物理上不存在的「空间契约」。
由此,「视听语言」这个概念本身正在解体。
它曾指向一个稳定的对象——电影院内、固定银幕上、标准音响系统中、完整时长内的视听体验。
如今,视听语言分散到无数屏幕尺寸、无数回放设备、无数观看环境中。
同一份「视听契约」的签署方式,在一个 IMAX 影厅和一块6.1英寸 OLED 屏幕上,存在本质差异。
这是教材尚未系统处理的问题。
2025年出版的《影视视听语言》第四版增补了「短视频创作」和「AIGC动态影像作品创作」章节。
2026年潘江军在哲学社会科学预印本平台提出「六声音统一场论」,试图以人物内心博弈为单一驱动源,构建统摄所有视听元素的整合模型,为AI影视内容生成提供可执行语法与品控标准。
学界正在追赶,但速度落后于媒介形态的裂变。
而问题的紧迫之处在于一个根本的认知偏差。
在「视听语言」被拆解为越来越细的技术参数的同时,「视听语言的本质是什么」这个问题反而越来越不被关心。
教材日益增厚,术语日益增多——杜比全景声的128个音频对象、空间音频的HRTF算法、AI驱动的自动混音——但很少有人被要求回答:学完所有这些,视听语言到底是什么。
可能大部分学生无法回答。
当然,这不是因为大家没有认真学习,而是因为教材压根没有提出这个问题。答案被默认隐含在目录结构里——「视听语言就是这些章节加在一起」。
但那不是答案,绝不是。
塔可夫斯基说,电影用时间雕刻而成。
希翁说,声音与画面之间的连接是一份契约。
麦茨说,电影是一种不是语言的语言,镜头是句子而非词语。
爱森斯坦说,声音必须与画面产生冲突,否则就是倒退。
这四组论证看似指向全然不同的方向,但底层逻辑却是相通的——视听语言的本质不在任何孤立元素中——不在镜头里,不在声音里,不在剪辑里。它在这些元素于时间中的关系里。 观众接收的不是「画面+声音+剪辑」的加法运算,而是一种多维度的、同步发生的、不可逆的感知重组过程。
这个过程是不是一种「语言」?
麦茨认为不是:它不能被翻译,不能被穷举,没有双层分节。
但麦茨可能低估了「语言」一词的弹性——如果将其从索绪尔的严格定义中释放出来,理解为「人类组织感知经验并将其传递给他人共享的一种结构化方式」,那么视听语言就是一种语言。
只是它的语法不在课本上,而在每一次观看经验中;它的词汇不是镜头类型,而是感知系统中那些被电影史和个人观影史训练出来的连接模式。
拍摄、剪辑、混音属于工具层面,六个月足够入门。
理解视听语言的本质,则涉及一个不断移动的目标——新的屏幕尺寸、新的声音格式、新的观看习惯持续改写规则。
但识别出这一点,本身就是从「语法等于语言」的体系中迈出的第一步。