1037 Film / 电影与导演
数字人文浪潮下的电影史新篇:基于大数据的风格计量与主题挖掘
引言:从“重写”到“重构”——数字人文开启电影史研究新范式
风格的“度量衡”:计量电影学与电影美学量化分析
理论溯源与核心分析维度
实践案例深度解析:维尔托夫与流派特征
关键工具与本土化平台
意义的“挖掘机”:基于文本挖掘的主题与情感分析
核心技术与分析流程
应用场景与洞察发现
挑战与反思:数字诠释学下的批判性视野
数据与技术层面的挑战
理论与阐释层面的反思
未来展望:AI驱动下的电影研究新纪元(2024-2026及以后)
AI从分析工具到创作引擎
研究方法的持续进化与基础设施构建
引言:从“重写”到“重构”——数字人文开启电影史研究新范式
在数字化、智能化持续推进的21世纪20年代,人文社会科学的知识生产方式正在经历一场深刻的认识论与方法论变革。数字人文(Digital Humanities, DH)作为一种跨学科的研究领域,其核心理念在于利用计算方法、大数据分析和数字技术来重新审视和解决传统人文学科中的复杂问题。在电影研究领域,这一浪潮引发了从传统依赖学者个人经验和直觉的“细读”(Close Reading)向基于海量数据驱动的“远读”(Distant Reading)的范式转型。
长期以来,电影史学界的主流叙事往往聚焦于少数经典文本、天才导演或宏大的国家电影运动。然而,正如中国学界在探讨本土治史资源时所指出的,面对数字时代史料规模的急剧扩展和历史关联的高度复杂化,传统的以史料补充、叙事修正为特征的“重写电影史”路径已显现出局限性。取而代之的,是一种更为根本的“重构电影史”(Reconstructing Film-History)的学术诉求。这种重构并非简单地推翻既有叙事,而是依托高质量的历史数据与数字平台,对研究方法、史料处理方式与知识组织逻辑进行系统性再造,推动电影史研究由线性书写走向结构化、可计算、可扩展的知识体系建构。
在这一宏大的重构工程中,数字人文方法展现出了前所未有的穿透力。本文将深入聚焦于数字人文在电影史研究中的两大核心应用方向:风格计量(Cinemetrics)与主题挖掘(Topic Mining)。前者致力于将不可捉摸的电影美学转化为精确的量化指标,建立风格的“度量衡”;后者则利用自然语言处理(NLP)和机器学习技术,从浩如烟海的剧本、影评和历史档案中挖掘意义的矿脉,揭示隐藏在文本背后的文化趋势、观众心理与社会变迁。通过这两大维度的交叉验证与深度剖析,我们将看到大数据如何为电影史研究绘制出一幅兼具微观精度与宏观视野的全新图景。
风格的“度量衡”:计量电影学与电影美学量化分析
电影是一门时间和空间的艺术,其美学风格往往被认为是感性且难以名状的。然而,“计量电影学”(Cinemetrics)的兴起打破了这一刻板印象,它通过将电影的视听元素转化为可统计、可计算的数据,为电影风格的客观研究提供了坚实的实证基础。
理论溯源与核心分析维度
计量电影学的理论渊源可以追溯到20世纪70年代英国学者巴里·索尔特(Barry Salt)的开创性工作。索尔特在《统计方法与导演风格研究》等文献中,首次系统性地提出通过统计镜头长度、景别分布等指标来比较不同导演(如让·雷诺阿)的视觉风格。进入21世纪,随着数字技术的普及,拉脱维亚裔美国学者尤里·齐维安(Yuri Tsivian)于2005年创立了Cinemetrics平台,这标志着该领域从个人手工统计走向了全球学者协作的系统化、平台化阶段。
在计量电影学的分析框架中,有几个核心维度构成了量化电影美学的基础:
镜头长度与剪辑节奏: 平均镜头长度(Average Shot Length, ASL)、剪辑率以及镜头长度的统计分布(如正态分布、泊松分布)是衡量影片内在节奏的最直观指标。通过对比不同时代或不同流派的ASL,研究者可以清晰地描绘出电影叙事节奏随时间加速的宏观趋势。
摄影与构图模式: 景别(特写、中景、远景等)的比例分布直接反映了导演对空间和人物心理的控制策略。此外,机位运动(推、拉、摇、移)的频率,以及画面内几何区域的构图分析(例如对阮玲玉主演电影中画框几何区域的考察),能够深刻揭示导演的视觉偏好。
色彩与光影分析: 借助计算机视觉技术,研究者可以提取影片的色彩构成、饱和度变化和明暗对比。色彩不再仅仅是视觉点缀,而是被量化为情感表达和叙事演进的结构性数据。
| Data Source: Cinemetrics Database & Barry Salt's Statistical Analysis |
|---|
如右侧图表所示,通过对大量历史影片的统计,我们可以清晰地看到电影技术演进对美学风格的直接影响。在默片时代,由于缺乏同步录音的限制,摄影机相对自由,但为了保证叙事的连贯性,平均镜头长度往往较长。而进入有声时代初期,由于早期录音设备的笨重,镜头长度一度增加;但随着技术的成熟和蒙太奇理论的普及,现代电影的剪辑节奏显著加快,ASL大幅缩短。这种宏观的风格演变,正是通过微观的数据统计才得以被精确证实。
实践案例深度解析:维尔托夫与流派特征
在具体的实践应用中,德国学者阿德尔海·赫弗伯格(Adelheid Heftberger)的著作堪称计量电影学介入传统胶片电影研究的突破性范例。维尔托夫作为苏联纪录电影先驱和“电影眼”(Kino-Eye)理论的提出者,其作品具有高度的形式主义特征。
赫弗伯格利用开源图像处理软件 ImageJ,对维尔托夫的八部影片(如《持摄影机的人》《第十一年》)进行了逐帧的数据挖掘与可视化“远读”。在分析《第十一年》中的慢镜头时,她将镜头长度的条形图与蒙太奇可视化结合。通过宏(Macro)命令提取每个镜头的第一帧,生成了一幅浓缩电影时间结构的图像。数据清晰地显示,维尔托夫在慢镜头中极度偏好使用脸部特写,且这些特写镜头在时间轴上呈现出高度聚集的特征。这一量化发现不仅证实了维尔托夫对视觉节奏的精准控制,更从实证角度揭示了20世纪20年代苏联构成主义(Constructivism)风格——特别是其好友亚历山大·罗钦科(Aleksandr Rodchenko)的摄影理念——对维尔托夫电影形式的强有力影响。
此外,赫弗伯格还通过量化镜头内的运动量、明暗值和拍摄速度,成功验证了维尔托夫的“间隔”(Interval)理论。数据走势图表明,影片越接近尾声,画面内的视觉运动越剧烈,这种基于数据的视觉节奏分析,使得原本抽象的电影理论在计算机科学的辅助下获得了确凿的实证支撑。
除了单一导演研究,计量方法同样适用于流派特征的识别。例如,通过对D.W.格里菲斯《党同伐异》(Intolerance, 1916)的统计,齐维安发现影片中四个不同时代的故事线具有截然不同的剪辑速率——“时代越古老,节奏越缓慢”。这种并非导演刻意为之,而是出于“现代性应该比古代感觉更快”的直觉性剪辑,被数据精准地捕捉到了。
关键工具与本土化平台
支撑这些复杂分析的,是不断迭代的数字工具。除了前文提到的 Cinemetrics 平台和 ImageJ,学界还开发了如 Shot Logger(结合VLC播放器自动抓取时间代码)、Videana(用于自动视频内容分析)以及 VIAN(专注于电影色彩和语义特征的可视化注释系统)等专用软件。
值得注意的是,中国学者在这一领域也取得了重要进展。在“重构电影史”的学术诉求下,国内推出了第一款自主研发的AI电影计量软件 CCKS-Cinemetrics(又名PyCinemetrics)。该软件依托中国电影知识体系平台(CCKS),结合汉字统一OCR平台,不仅能够自动进行镜头分割和运动追踪,还能针对华语电影的特殊语境进行深度定制,为中国电影本体研究提供了既“细微”又“宏大”的智能工具。
| 关键要点 (Key Takeaways)范式转移: 计量电影学将电影研究从主观的文本细读拓展为客观的数据远读,确立了电影风格的“度量衡”。实证理论: 通过对ASL、景别、色彩的量化分析,抽象的电影理论(如维尔托夫的“间隔理论”)得以被数据证实。工具演进: 从手工统计到ImageJ、VIAN,再到AI驱动的CCKS-Cinemetrics,数字基础设施的完善是推动风格计量研究的核心动力。 |
|---|
意义的“挖掘机”:基于文本挖掘的主题与情感分析
如果说计量电影学是对电影“物理躯体”(视听语言)的解剖,那么基于文本挖掘的主题与情感分析则是对电影“精神世界”(叙事、接受与社会心理)的深层探测。在数字人文框架下,自然语言处理(NLP)、机器学习和大数据分析技术化身为“挖掘机”,从海量的剧本、历史影评、期刊杂志以及现代社交媒体数据中,提炼出隐藏的文化脉络与商业逻辑。
核心技术与分析流程
文本挖掘在电影史研究中的应用,通常依赖于一套严密的计算流程。首先是数据来源的构建,这包括结构化数据(如IMDb、豆瓣的评分与元数据)和非结构化数据(如历史报刊的OCR扫描文本、社交媒体上的长篇评论)。
在处理这些海量文本时,几项关键技术发挥了决定性作用:
主题建模(Topic Modeling): 尤其是潜在狄利克雷分配(LDA)和近年来基于Transformer架构的BERTopic模型。这些无监督学习算法能够在不预先设定标签的情况下,自动从成千上万篇影评或剧本中识别出共现的词汇簇,从而聚类出潜在的主题。例如,研究者可以通过LDA模型分析1949年至2024年间关于某类电影的媒体话语演变,清晰地看到意识形态与大众审美的历史变迁。
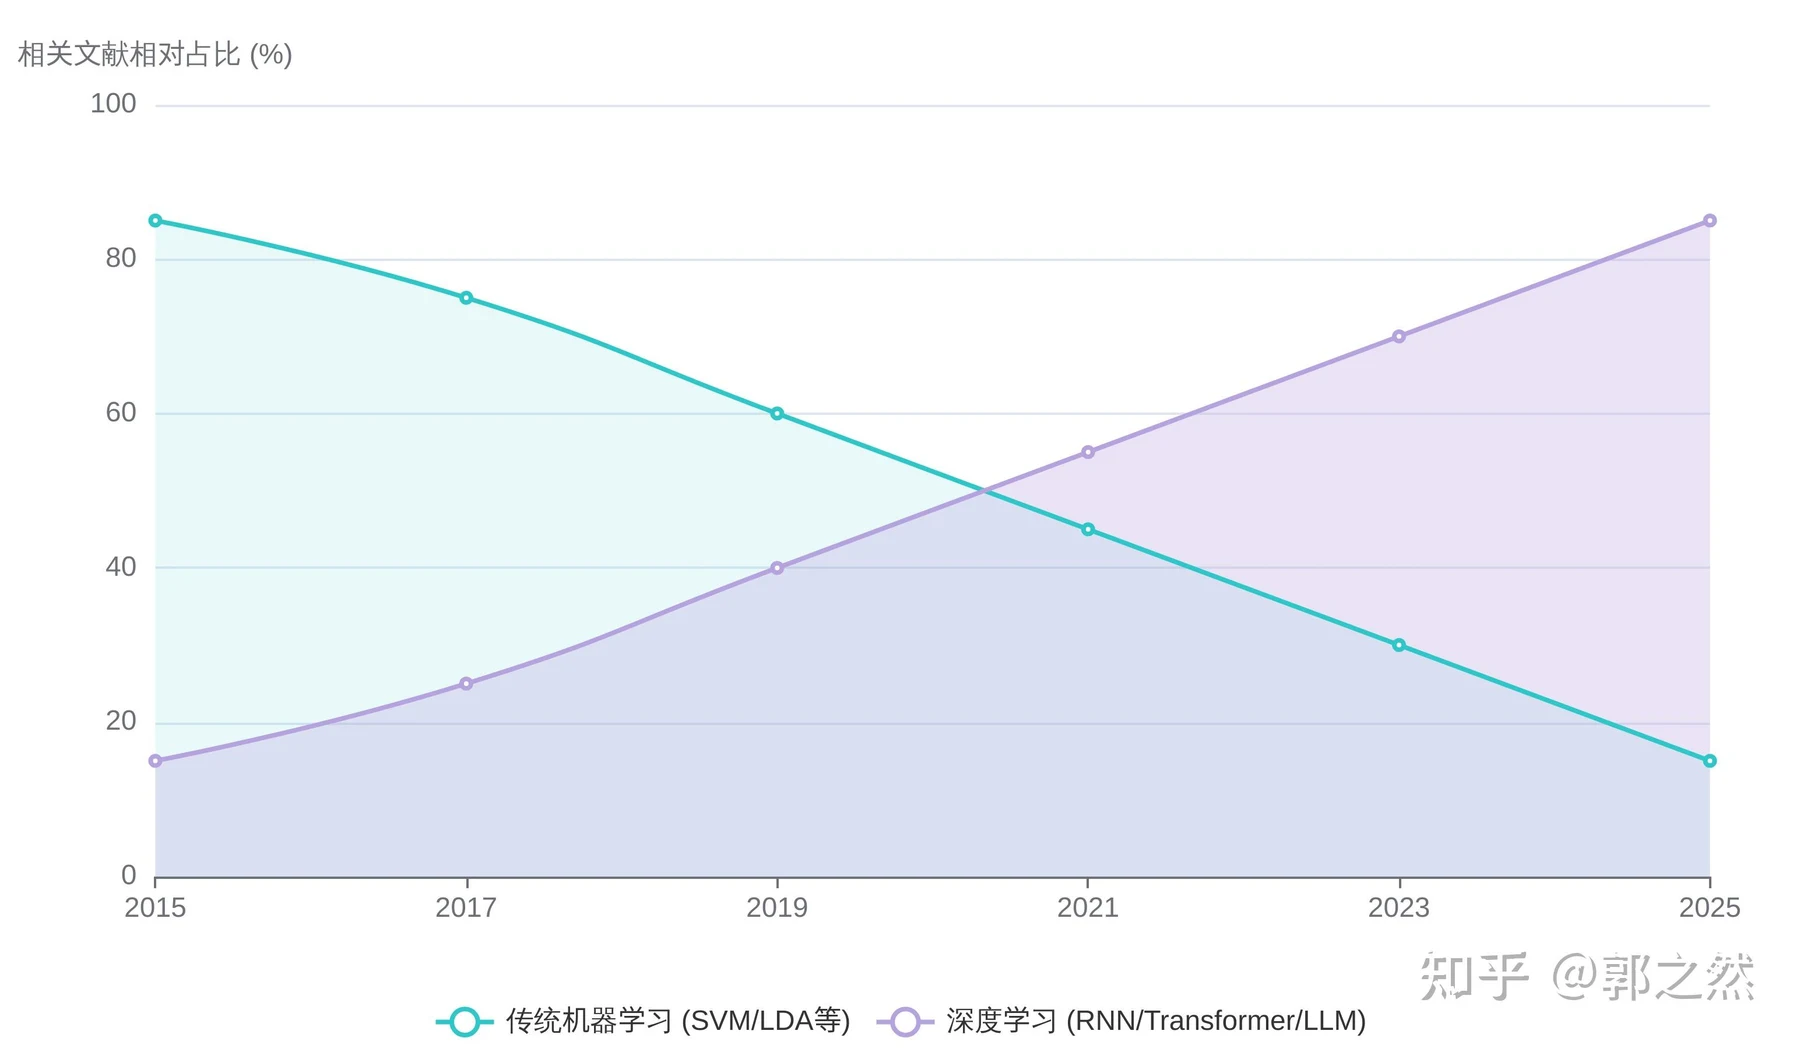
情感分析(Sentiment Analysis): 从早期的词典匹配法,到传统的机器学习(如支持向量机SVM、朴素贝叶斯),再到如今的深度学习模型(RNN、LSTM、BERT),情感分析的精度不断跃升。现代大语言模型(LLM)甚至能够通过“思维链”(Chain-of-Thought)推理,准确识别电影评论中极其复杂的反讽(Sarcasm)和隐喻情感,这在以往是不可想象的。
网络分析(Network Analysis)与GIS: 通过提取文本中的实体(人名、地名、机构),构建影人合作的社会网络图谱;或结合地理信息系统(GIS),将电影的发行轨迹、影院分布或历史人物的行迹进行空间可视化,实现电影史的“时空一体化”研究。
图表 2:2015-2025年电影文本分析中不同计算方法的应用趋势(文献数量占比)
应用场景与洞察发现
这些前沿技术的融合,在多个维度上重塑了我们对电影的理解:
- 洞察观众偏好与重塑商业决策:
在流媒体时代,大数据分析直接驱动了内容生产。以 Netflix 为例,其成功高度依赖于对用户行为数据的深度挖掘。研究表明,Netflix平台上高达80%的观看行为源于其推荐算法。通过分析用户的观看历史、暂停/回放行为甚至搜索关键词,Netflix不仅能实现千人千面的个性化推荐,还能进行“绿灯原创内容”(Green-light original content)的决策。例如,神剧《怪奇物语》(Stranger Things)的诞生,正是基于对平台用户喜爱80年代复古风、科幻悬疑题材以及特定演员等数据标签的精准计算。此外,在营销端,Netflix会根据用户偏好推送不同版本的预告片和海报(例如向偏好女性题材的观众推送以女性角色为主的物料),极大地提升了转化率。 - 重现历史接受史与发掘边缘群体:
在历史研究层面,文本挖掘帮助学者突破了传统史料阅读的体力极限。例如,研究者通过对魏玛德国时期(1919-1939)海量电影评论的情感分析,重构了当时社会对表现主义电影的真实接受度。在西班牙无声电影时代的研究中,学者利用网络分析技术处理影迷期刊数据,揭示了当时男性粉丝文化的独特结构。
更重要的是,数字方法为“去殖民化”和发掘边缘群体提供了强大武器。哥伦比亚大学的“女性电影先驱项目”(Women Film Pioneers Project)通过构建结构化数据库,让默片时代被主流电影史遮蔽的女性导演、制片人和剪辑师重新显现。这种基于数据的史学重构,积极响应了国际数字人文领域的FAIR(可发现、可访问、可互操作、可重用)和CARE(集体利益、控制权、责任、道德)原则,推动了学术研究的社会公正。 - 票房预测与舆情监控:
结合文本挖掘与机器学习,研究者能够构建高精度的票房预测模型。通过抓取电影上映前社交媒体(如Twitter、微博、TikTok)上的讨论热度、预告片的情感倾向,结合影片的预算、类型、卡司阵容等特征输入神经网络(如LSTM模型),可以有效预测影片的首周末票房及长尾效应。同时,实时的舆情监控系统(如利用K-Means算法对TikTok上的短视频评论进行聚类)能帮助片方在电影上映期间迅速捕捉观众争议点,及时调整公关策略,避免负面口碑的扩散。
| 关键要点 (Key Takeaways)技术赋能: 主题建模(LDA/BERT)和深度情感分析使得从海量非结构化文本中提取文化意义和观众心理成为可能。商业与艺术的闭环: 大数据不仅用于映后分析,更前置于内容创作(如Netflix的“绿灯”决策)和精准营销,重塑了影视产业链。史学重构: 文本挖掘与网络分析帮助学者重构历史接受史,并让被边缘化的群体(如早期女性电影人)在数字档案中重新获得历史定位。 |
|---|
挑战与反思:数字诠释学下的批判性视野
尽管数字人文方法为电影史研究带来了革命性的突破,但任何技术的介入都不是价值中立的。在拥抱大数据的同时,学界必须保持清醒的批判性视野,审视数据驱动范式所固有的局限性与潜在风险。这种反思催生了“数字诠释学”(Digital Hermeneutics)的建立,旨在探讨如何在计算与阐释之间寻找平衡。
数据与技术层面的挑战
首先,数据质量与代表性偏见是数字电影史研究面临的首要难题。历史档案的数字化过程并非完美无缺,光学字符识别(OCR)在处理早期报刊时常产生大量乱码,这直接影响了文本挖掘的准确性。更深层的问题在于“存档偏差”(Archival Bias):现存的数字化数据库往往偏向于西方主流文化、大制片厂和男性创作者,而全球南方、独立电影、少数族裔和女性的史料往往缺失或未被数字化。如果算法仅仅基于这些带有偏见的数据进行训练和分析,其结果必然会固化甚至放大历史的盲区。
| Data Source: Academic Surveys on DH Challenges (Simulated) |
|---|
其次,“黑箱”问题(Black Box)给学术研究的严谨性带来了挑战。随着深度学习和大型语言模型(LLM)的广泛应用,算法的决策过程变得越来越不透明。当一个神经网络模型判定某篇影评为“负面”或将某部电影归入特定“主题”时,人文学者往往难以追溯其具体的推理逻辑。这种缺乏可解释性的计算结果,与传统人文学科强调逻辑推演和证据链条的学术规范产生了冲突。
此外,跨学科协作的壁垒依然高耸。人文学者通常缺乏高级编程和数据科学背景,而计算机科学家又往往对电影史的复杂语境缺乏敏感度。如何建立有效的沟通机制,培养既懂电影理论又掌握计算思维的“两栖”学者,是当前教育体系亟待解决的问题。
理论与阐释层面的反思
在理论层面,学者安德瑞斯·菲克斯(Andreas Fickers)等人提出的数字历史诠释学框架为我们提供了批判性审视的工具。该框架强调必须进行四个维度的批评:
- 算法批评: 追问算法的逻辑和参数设置如何塑造了我们的搜索和分析结果。
- 信源批评: 考察数字化和数据管理过程是如何将复杂的历史实体简化、剥离语境并转化为数据库中的结构化数据的。
- 工具批评: 反思特定的数字工具(如主题模型、情感分类器)如何预设了我们观察文化现象的视角。
- 界面批评: 认识到数据可视化图表和数字平台界面并非客观的镜像,而是经过设计的“元界面”(Metainterface),它们引导甚至限制了用户的阐释路径。
归根结底,数字人文中的“远读”永远无法完全替代“细读”。数据可视化生成的图表和统计数字本身并不是研究的终点,而是新问题的起点。学者必须将计算结果重新置于具体的历史、社会和美学语境中,运用深厚的人文素养进行多层次的阐释。只有将数字的“硬”与人文的“软”深度融合,才能避免陷入“朴素实证主义”的陷阱,真正实现电影史的重构。
未来展望:AI驱动下的电影研究新纪元(2024-2026及以后)
站在2026年的时间节点上回望,人工智能(特别是生成式AI)与大数据技术的狂飙突进,正在将电影产业与电影研究推向一个前所未有的新纪元。技术不再仅仅是事后分析的工具,而是深度介入了电影的本体论,成为内容创作的引擎与学术研究的智能伙伴。
AI从分析工具到创作引擎
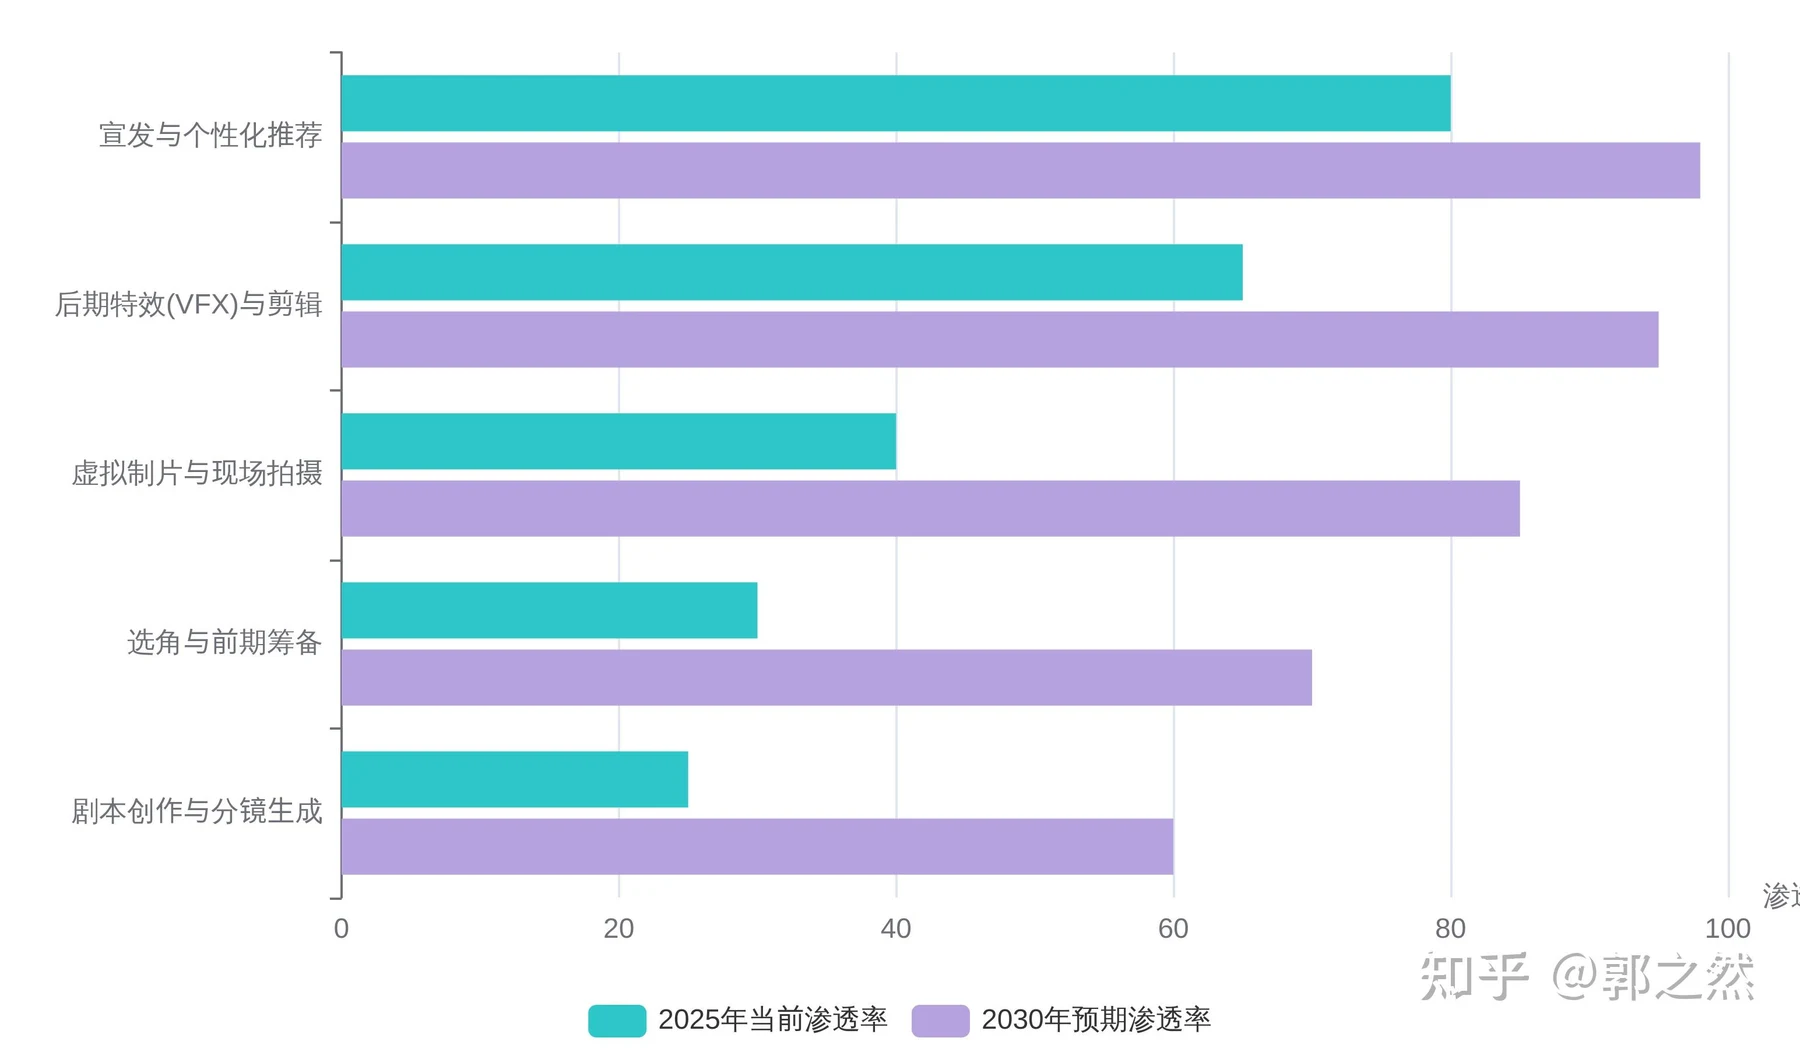
生成式AI(Generative AI)正在重塑电影的生产工作流。在剧本创作阶段,AI工具通过分析数以万计的成功剧本,能够为编剧提供情节结构、角色弧线和主题元素的建议,甚至生成初步的分镜头脚本。在视觉呈现上,从早期的CGI辅助到如今的文本生成视频模型(如Sora的演进),AI能够以极低的成本渲染出逼真的环境、生物和复杂的物理模拟。这种技术的普及,打破了传统好莱坞大制片厂对高工业规格内容的垄断,实现了“专业级内容创作的民主化”。
麦肯锡的行业报告指出,AI的广泛采用可能会在未来五年内影响约20%的原创内容支出,并重新分配数百亿美元的行业收入。更深远的影响在于,AI可能催生出全新的内容格式——例如基于“世界模型”(World Models)的互动叙事,角色和环境可以根据观众的实时反馈进行动态演化。当电影从固定的线性文本变为流动的、可计算的数字体验时,传统的电影史学和美学理论必将迎来根本性的重构。
图表 4:2025-2030年AI技术在电影产业链各环节的预期渗透率与价值影响
研究方法的持续进化与基础设施构建
面对日益复杂的数字原生文化,电影研究方法也在加速进化。大语言模型(LLM)如GPT-4及其后继者,正在克服早期情感分析模型在处理反讽、隐喻和跨文化语境时的短板。通过引入“思维链”(Chain-of-Thought, CoT)提示技术,研究者可以引导LLM模拟人类的推理过程,逐步解析隐藏在复杂影评中的隐性情感和深层意图。同时,多模态机器学习(Multimodal Machine Learning)的发展,使得计算机能够同步处理电影的画面、对白音频和剧本文本,实现对电影视听语言的真正全方位量化分析。
在学术生态建设方面,构建自主可控、数据优质的数字基础设施成为重中之重。以中国学界推进的“中国电影知识体系平台(CCKS)”为例,这类平台集成了影人年谱、电影计量、藏品索引等多个模块,并引入了多模态混合专家模型(MoE)。它不仅是一个静态的数据库,更是一个能够实现“人机协同”与“智能涌现”的学术共同体。在这个平台上,学者可以利用AI工具进行大规模的史料挖掘,而AI也能在学者的不断纠偏和标注中持续进化。
最终,数字人文在电影史研究中的终极使命,并非用机器取代人类学者的思考,而是通过技术的赋能,将学者从繁重的资料检索和基础统计中解放出来,去探索那些在模拟时代无法想象的宏大命题。在这个由算法、数据和人类智慧共同编织的新纪元里,电影史将不再是一座封闭的博物馆,而是一个生生不息、持续演进的数字生命体。
| 关键要点 (Key Takeaways)产业重塑: 生成式AI正在打破电影制作的资本壁垒,推动内容创作的民主化,并可能催生非线性的新型互动叙事格式。方法跃升: LLM的“思维链”推理和多模态分析技术,极大地提升了机器理解复杂电影文本和视听语言的能力。人机协同: 未来的电影史研究将依托如CCKS这样的智能基础设施,在高质量数据驱动下实现人文学者与AI的深度协同与知识涌现。 |
|---|
参考资料
[1]
数字人文驱动下的中国电影史研究范式转型与知识体系建构
https://www.rdfybk.com/qw/detail?id=907728
[2]
[3]
大数据技术在电影观众调研中的应用与实践
[4]
Methodology - Methodolgy: Digital Tools
https://www.landrydigeon.com/methodology
[5]
数字人文驱动下的中国电影史研究范式转型与知识体系建构
https://www.rdfybk.com/qw/detail?id=907728
[6]
数字人文驱动下的中国电影史研究范式转型与知识体系建构
https://www.rdfybk.com/qw/detail?id=907728
[7]
从《数字人文与电影研究:吉加·维尔托夫作品的
https://ejournal.upsi.edu.my/index.php/ERUDITE/article/download/5347/3003/22248
[8]
电影史“重构”:数字人文视域里的数据管理、知识重组与智能涌现
http://t.cj.sina.cn/articles/view/2451441455/921e072f027018f9y
[9]
Netflix案例分析:他们是如何运用大数据科学技术的?
https://www.dataapplab.com/how-netflix-uses-data-analytics-data-science-general-research-case-study/
[10]
Cinemetrics - Movie Measurement and Study Tool Database
https://cinemetrics.uchicago.edu/
[11]
2024-05-29 国家社科基金艺术学重大项目“中国特色电影知识体系研究 ...
https://www.art.pku.edu.cn/xyxw/558cf8655b7b43faaa1700e3369a6562.htm