1037 Film / 产业与媒介
观众对AIGC内容的“真实感”感知与信任度研究
- 引言
进入21世纪20年代中期,人工智能技术迎来了爆发式增长,特别是以大语言模型(Large Language Models, LLMs)和扩散模型(Diffusion Models)为代表的生成式人工智能技术的成熟,标志着人类社会正式迈入AIGC(AI-Generated Content)时代。从OpenAI的GPT-4、Sora,到Midjourney、Stable Diffusion,这些强大的AI工具不仅能够生成逻辑严密、文采斐然的文本,还能创造出达到照片级真实感的图像和符合物理规律的高清视频。AIGC正在以前所未有的速度和规模重塑媒体、教育、医疗、娱乐和商业营销等各个领域[1]。
根据皮尤研究中心(Pew Research Center)2025年6月的最新调查数据显示,公众对AI的认知和使用率正在持续攀升。几乎所有美国成年人都表示至少听说过一点关于AI的信息,其中47%的人表示“听说过很多”,这一比例较2022年的26%有了大幅提升。此外,31%的受访者表示他们每天至少与AI互动几次,而在年轻群体(18-29岁)中,这一比例更是高达53%[2]。
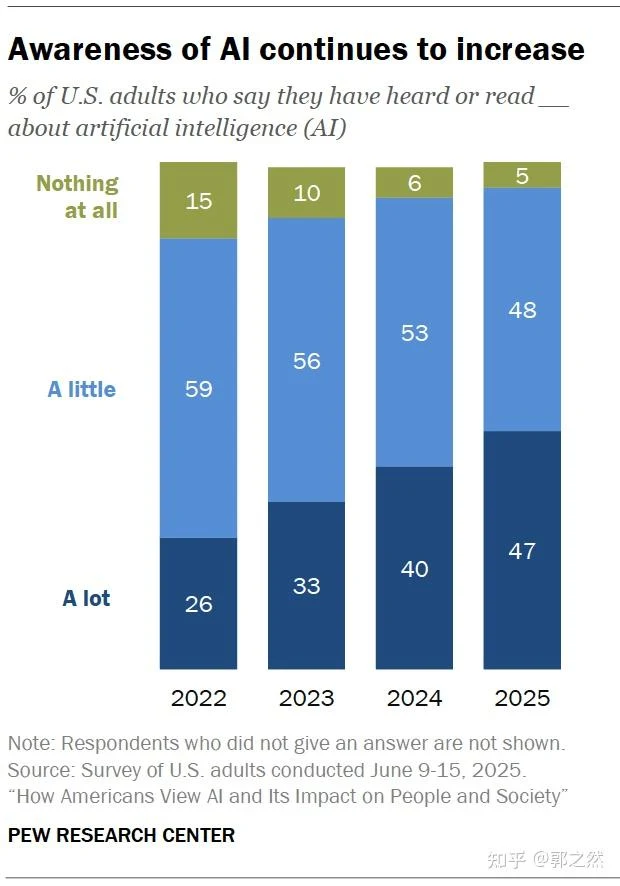
图1:公众对人工智能(AI)的认知度持续上升趋势(2022-2025)。数据来源:Pew Research Center
在职场和教育领域,AIGC的渗透同样深远。数据显示,表示在工作中使用AI的美国员工比例已从2024年的16%上升至2025年9月的21%[3]。在青少年群体中,AIGC工具(如AI聊天机器人)的使用已成为常态。约64%的13至17岁美国青少年表示曾使用过AI聊天机器人,主要用于搜索信息(57%)和辅助学业(54%)[4]。
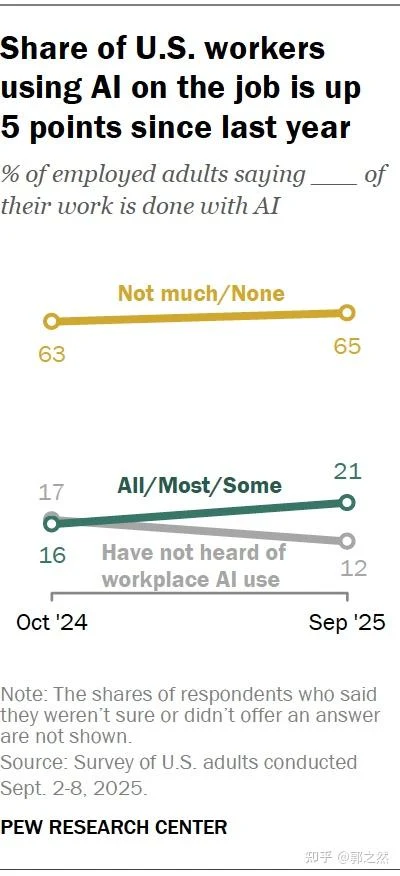
图2:美国员工在工作中使用AI的比例变化(2024-2025)。数据来源:Pew Research Center
然而,随着AIGC生成的内容在质量上越来越难以与人类创作的内容相区分,一系列深刻的认知、心理和伦理问题随之浮现。当受众面对一段视频、一篇文章或一张图片时,他们如何判断其“真实性”?这种对真实感的感知又如何影响他们对信息来源的信任?在虚假信息(Misinformation)、深度伪造(Deepfakes)和“幻觉”(Hallucinations)频发的背景下,探讨受众对AIGC内容的真实感感知与信任度机制,不仅具有重要的学术价值,更是维护数字社会信息生态健康的迫切需求。
本研究旨在回答以下核心问题:第一,受众在多大程度上能够准确识别AIGC内容与人类生成内容?第二,AIGC内容的哪些特征影响了受众的真实感感知?第三,信息来源的披露(即AI标签)如何调节受众的信任度?第四,在不同应用场景(如医疗、教育、营销)中,受众对AIGC的信任机制是否存在差异?
- 文献综述与理论基础
2.1 AIGC的技术演进与生成机制
AIGC的繁荣建立在深度学习(Deep Learning)技术的突破之上,其中最核心的架构是Transformer模型和扩散模型(Diffusion Models)。理解这些底层技术有助于我们剖析AIGC内容为何能具备如此高的“真实感”。
2.1.1 Transformer架构与文本生成
Transformer架构由Google研究人员于2017年提出,彻底改变了自然语言处理(NLP)领域。与传统的循环神经网络(RNN)不同,Transformer能够同时处理整个输入序列,极大地提高了并行计算效率和对长距离上下文的理解能力。Transformer的核心包含编码器(Encoder)和解码器(Decoder)两个主要部分。
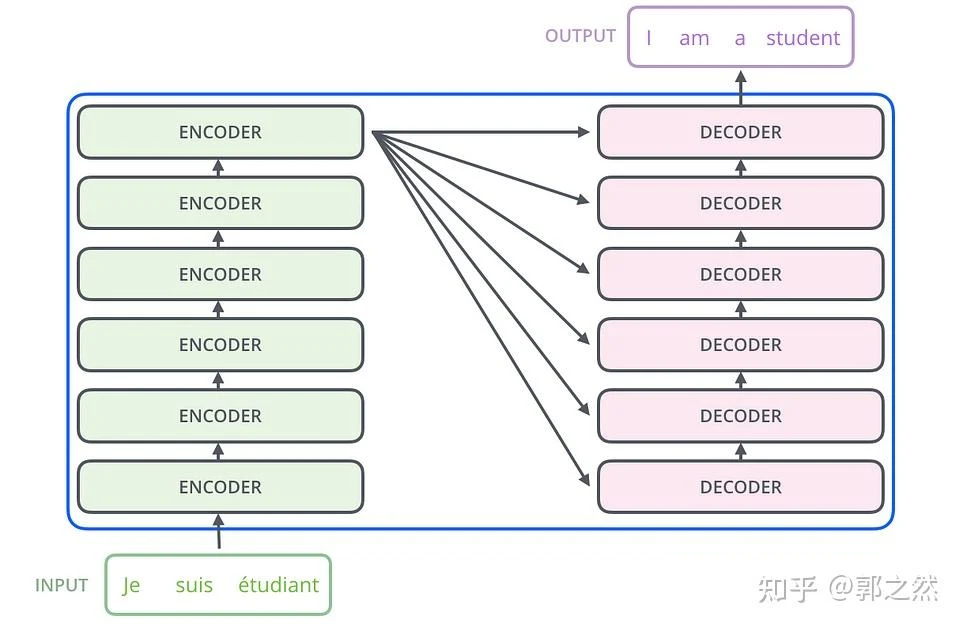
图3:Transformer架构的编码器-解码器(Encoder-Decoder)结构示意图。左侧为编码器堆栈,右侧为解码器堆栈。
在Transformer中,最关键的创新是“自注意力机制”(Self-Attention Mechanism)。该机制允许模型在处理序列中的某个词时,动态地评估句子中其他所有词对该词的重要性(权重)。例如,在句子“The animal didn't cross the street because it was too tired”中,自注意力机制能够准确地将代词“it”与“animal”联系起来,而不是“street”。这种对上下文的深度理解使得大语言模型(如GPT-4)能够生成高度连贯、符合逻辑且具有人类语言习惯的文本[5]。
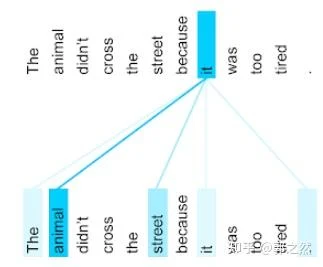
图4:自注意力机制可视化。线条的粗细和颜色深浅表示代词“it”对句子中其他单词的注意力权重,准确地指向了“animal”。
此外,多头注意力(Multi-Head Attention)机制允许模型从多个不同的表征子空间(如语法、语义、情感等)同时捕捉信息,进一步丰富了模型对文本的理解维度。正是基于这些复杂的神经网络架构,AIGC文本在语法正确性、逻辑连贯性和语境适应性上达到了前所未有的高度,使得受众在阅读时极易产生“这是由人类专家撰写”的错觉。
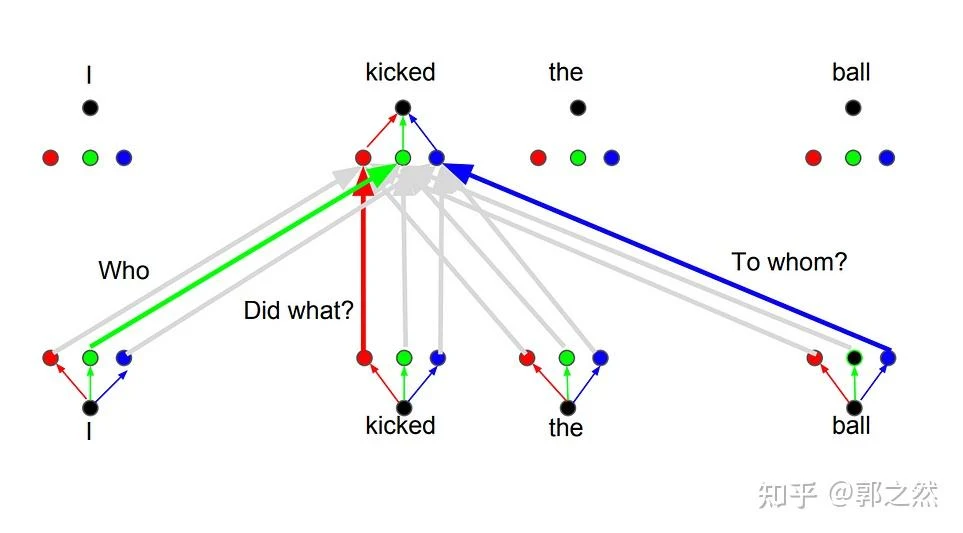
图5:多头注意力机制(Multi-Head Attention)工作原理示意图。模型通过多个“头”并行处理信息,捕捉不同的语言特征。
2.1.2 扩散模型与视觉内容生成
在图像和视频生成领域,扩散模型(如Stable Diffusion, Midjourney)成为了主流。扩散模型的工作原理分为前向过程(添加噪声)和反向过程(去除噪声)。在训练阶段,模型学习如何将一张清晰的真实图像逐步添加高斯噪声,直到其变成纯噪声;在生成阶段(推理阶段),模型从纯随机噪声开始,根据用户输入的文本提示(Prompt),通过U-Net等神经网络逐步预测并去除噪声,最终还原出符合描述的清晰图像[6]。
Stable Diffusion的一个重大创新是将扩散过程从高维的像素空间转移到了低维的“潜在空间”(Latent Space)。通过变分自编码器(VAE)对图像进行压缩,模型在潜在空间中进行去噪计算,极大地降低了计算资源的消耗,使得在消费级硬件上生成高分辨率、高真实感的图像成为可能。这种技术生成的图像在光影、纹理、透视关系上高度逼真,直接挑战了人类视觉系统的辨别能力。
2.2 真实感感知的理论基础
在心理学和传播学中,“真实感”(Perceived Realism)是指受众认为媒介内容在多大程度上反映了客观现实。对于AIGC内容,真实感感知不仅取决于内容的物理逼真度(如图像的分辨率、光影的自然度),还取决于语义的合理性(如文本的逻辑性、情感的真挚度)。
传统的“恐怖谷理论”(Uncanny Valley Theory)认为,当非人类实体(如机器人或动画角色)的外表和动作越来越接近人类时,人们对其的好感度会增加;但当相似度达到一个临界点,哪怕只有微小的瑕疵,也会引发人们强烈的反感和不安。然而,随着AIGC技术的进步,许多研究表明,当前的AI生成图像和视频已经开始跨越恐怖谷。例如,Nightingale和Farid(2022)的研究发现,AI合成的人脸不仅与真实人脸难以区分,甚至在某些情况下被受众认为比真实人脸“更值得信任”[7]。这表明,AIGC在视觉表征上已经具备了极强的欺骗性。
2.3 信任度与来源可信度理论
信任(Trust)是人际交往和社会运作的基石。在媒介心理学中,来源可信度理论(Source Credibility Theory)是解释受众如何评估信息可信度的核心框架。该理论由Hovland和Weiss(1951)提出,认为信息来源的可信度主要由两个维度构成:专业性(Expertise)和值得信赖性(Trustworthiness)[8]。
专业性:指信息来源被认为具备提供准确、有效信息的知识、技能和经验的程度。
值得信赖性:指信息来源被认为客观、诚实、没有偏见或自私动机的程度。
在AIGC语境下,来源可信度面临着复杂的重构。一方面,受众可能基于“机器启发式”(Machine Heuristic)——即认为机器和算法比人类更客观、更少偏见、处理信息能力更强——而赋予AI极高的专业性信任。另一方面,由于AI缺乏人类的情感、道德责任感和真实的生活经验,受众可能对其“值得信赖性”和“真实意图”产生怀疑。这种矛盾构成了AIGC信任度研究的核心张力。
2.4 标签效应与算法厌恶
大量实证研究表明,是否披露内容由AI生成(即添加AI标签)对受众的信任度有决定性影响。这种现象被称为“标签效应”。研究发现,在盲测(未告知来源)情况下,受众往往对AI生成的高质量内容给予高度评价;但一旦被告知内容是AI生成的,受众的评价和信任度会显著下降。这种现象与“算法厌恶”(Algorithm Aversion)理论相吻合,即人们在面对相同质量甚至更高质量的算法决策时,仍然偏好人类决策,尤其是在涉及道德、医疗、艺术等被认为需要“人类特质”的领域[9]。
- 研究假设与理论模型
基于上述文献综述,本研究结合来源可信度理论和技术接受模型,提出以下研究假设:
H1(识别能力假设):在无辅助提示的情况下,受众无法准确区分AIGC内容与人类生成内容,其识别准确率接近随机水平(约50%)。
H2(真实感感知假设):AIGC内容在视觉和语义上能够产生高度的真实感,但在细微的逻辑连贯性或物理细节上,人类生成内容仍被感知为略微更真实。
H3(标签悖论假设):在盲测条件下,受众对AIGC内容的信任度等于或高于人类内容;但当明确标注“AI生成”标签时,受众的信任度会显著下降。
H4(场景调节假设):受众对AIGC的信任度受应用场景的调节。在客观性强、数据驱动的场景(如编程、数据分析)中信任度较高;在主观性强、涉及情感或高风险的场景(如医疗诊断、艺术创作)中信任度较低。 - 研究方法
为全面验证上述假设,本研究采用混合研究方法(Mixed-Methods Approach),结合了大规模在线问卷调查、受控行为实验以及生理数据监测,以多维度捕捉受众的认知与心理反应。
4.1 研究一:AIGC认知与使用现状调查
本部分基于Pew Research Center及Data for Progress的最新全国性调查数据,分析了不同人口统计学群体对AI的认知度、使用频率及总体态度。样本涵盖了美国各年龄段、性别、种族及教育背景的成年人及青少年群体,以描绘AIGC在社会层面的宏观接受图景。
4.2 研究二:视觉内容的真实感与来源识别实验
为测试受众对AIGC视觉内容的识别能力(H1)和真实感感知(H2),本研究设计了一项受控实验。实验选取了161名参与者(包括71名视觉专业人士和90名非专业人士)。刺激材料包含32张图像,分为四类:人物肖像、风景、日常场景和细节物体。每类包含6张由主流AI工具(Midjourney, DALL·E 3, Adobe Firefly)生成的图像和2张人类拍摄的真实照片(比例为3:1)。
参与者被要求对每张图像进行两项评估: - 来源识别:判断图像是“AI生成”还是“人类创作”。
- 真实感评分:使用5点李克特量表(1=完全不真实,5=完全真实)对图像的逼真程度进行打分。
4.3 研究三:医疗健康信息中的信任度与标签效应实验
为验证标签悖论(H3)和场景调节效应(H4),本研究在医疗健康信息领域开展了一项2×2的混合设计实验。自变量包括:信息实际来源(人类医生 vs. 大语言模型LLM)和披露标签(标注为“人类医生” vs. 标注为“AI”)。
实验招募了210名参与者,要求他们阅读关于特定健康问题(如持续性头痛)的诊断建议。除了收集自我报告的信任度评分(5点李克特量表)外,实验还引入了眼动追踪(Eye-tracking)和生理信号监测(如心率变异性HRV、皮肤温度),以捕捉受众在阅读不同标签信息时的隐性认知负荷和情绪反应。
- 数据分析与结果
5.1 AIGC的社会认知与使用鸿沟
宏观调查数据显示,AIGC的普及速度惊人,但存在显著的人口统计学差异。在青少年群体中,AI聊天机器人的使用率高达64%。如图6所示,青少年使用AI的主要目的集中在信息搜索(57%)和学业辅助(54%)。值得注意的是,有10%的青少年表示他们“全部或大部分”的学业任务都是在AI的帮助下完成的,这引发了教育界对学术诚信和过度依赖的担忧。
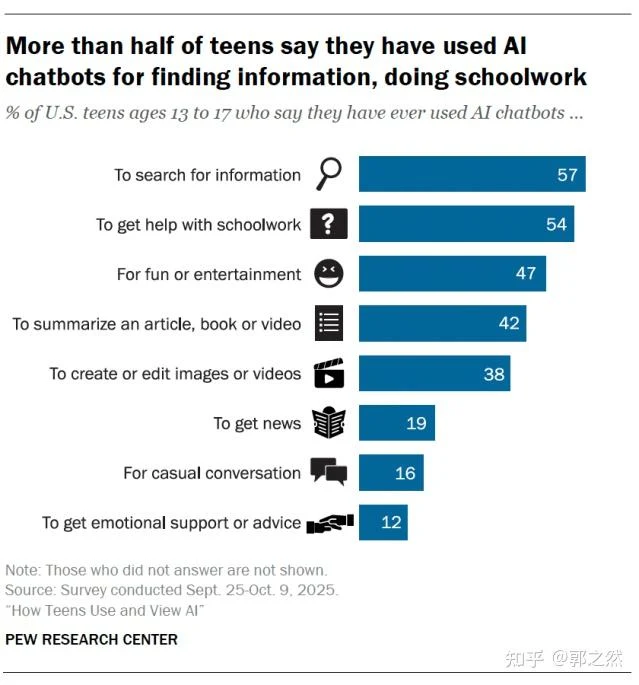
图6:美国青少年(13-17岁)使用AI聊天机器人的主要目的分布。数据来源:Pew Research Center (2025)
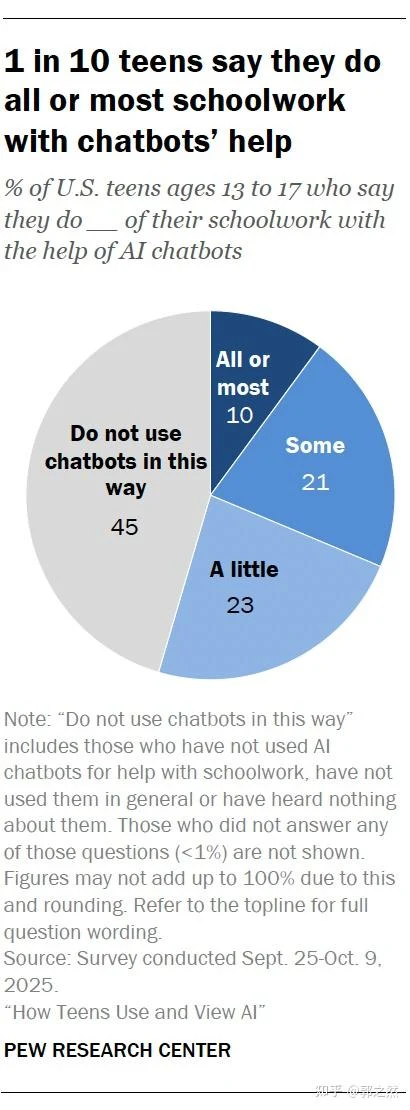
图7:青少年在学业任务中依赖AI聊天机器人的程度。10%的受访者表示“全部或大部分”依赖AI。数据来源:Pew Research Center (2025)
在成年人群体中,年龄和技术熟悉度是决定AI态度的关键因素。18-29岁的年轻成年人中,有62%表示对AI非常了解,53%每天至少与AI互动一次;而在65岁以上的老年群体中,这两个比例分别骤降至32%和30%。此外,频繁使用AI的用户对其持积极态度的比例(净支持率+57%)远高于极少使用AI的用户(净支持率-42%)。这表明,实际的使用体验是建立AIGC信任的最强预测因子。
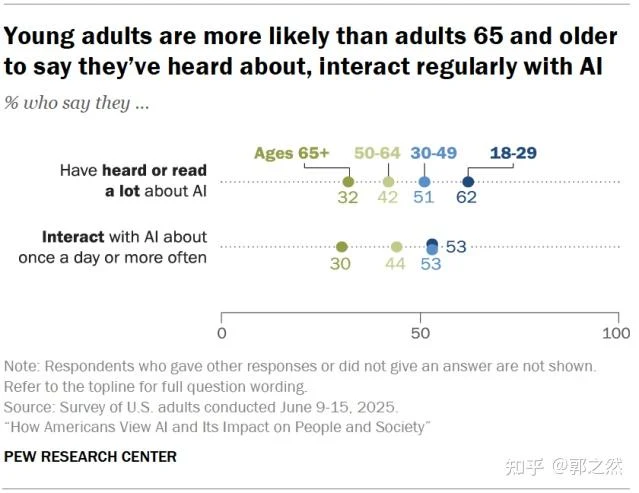
图8:不同年龄段美国成年人对AI的认知度与日常互动频率对比。年轻群体显著高于老年群体。
5.2 视觉内容的“硬币抛掷”:识别能力与真实感
在视觉内容识别实验(研究二)中,共收集了5152份有效评估。数据分析揭示了一个令人震惊的事实:人类在识别AI生成图像时的整体准确率仅为51.24%,几乎等同于抛硬币的概率(Coin Toss)。
具体而言,在所有AI生成的图像中,有38.92%被受试者错误地判定为“人类创作”;而在真实的人类照片中,也有21.74%被误判为“AI生成”。这充分支持了H1假设,即当前的AIGC技术已经成功跨越了人类视觉感知的初步防线。
| 感知来源 \ 实际来源 | AI生成图像 (N=3864) | 人类创作图像 (N=1288) |
|---|---|---|
| 被判定为“AI生成” | 2360 (61.08%) | 280 (21.74%) |
| 被判定为“人类创作” | 1504 (38.92%) | 1008 (78.26%) |
在真实感评分方面,人类创作的图像平均得分为4.22(满分5分),略高于AI生成图像的3.58分。这表明,尽管AI图像极具欺骗性,但在仔细审视下,受众仍能隐约察觉到AI图像在某些细节(如光影逻辑、复杂纹理)上的不自然,从而给予相对较低的真实感评分。这一结果支持了H2假设。此外,视觉专业人士在识别准确率上(62.09%)略高于非专业人士(60.28%),且专业人士对所有图像的真实感评分普遍更高,这可能反映了专业人士对现代数字图像处理技术的更高包容度。
5.3 医疗健康领域的“标签悖论”
在医疗健康信息信任度实验(研究三)中,数据呈现出高度复杂的交互效应。在盲测(未告知实际来源)的情况下,受众对LLM生成的医疗建议的信任度评分(M=3.97)显著高于人类医生提供的建议(M=3.89,p=0.024)。定性访谈显示,受众认为LLM生成的文本结构更清晰、信息更全面、语气更客观,这触发了受众的“机器启发式”信任,认为算法比人类更具专业性和中立性。
然而,当引入“标签”变量后,情况发生了逆转。无论信息的实际来源是什么,只要被贴上“AI生成”的标签,其信任度评分(M=3.82)便显著低于被贴上“人类医生”标签的信息(M=4.04,p<0.001)。最有趣的是,实际由LLM生成但被贴上“人类”标签的信息获得了全场最高的信任评分(M=4.07),而实际由人类撰写但被贴上“AI”标签的信息得分最低(M=3.76)。
| 实际来源 \ 披露标签 | 标注为“人类医生” | 标注为“AI生成” |
|---|---|---|
| 人类医生撰写 | 4.01 (SD=0.45) | 3.76 (SD=0.64) |
| LLM生成 | 4.07 (SD=0.47) | 3.87 (SD=0.44) |
这一结果完美验证了H3假设(标签悖论)。生理数据监测进一步证实了这一点:当受试者阅读带有“AI”标签的医疗信息时,其心率变异性(HRV)发生显著变化,瞳孔扩张度增加,表明受试者在处理AI信息时产生了更高的认知负荷、警惕性甚至轻微的焦虑情绪。这种隐性的生理反应与显性的信任度评分下降高度一致。
- 讨论
6.1 AIGC真实感与人类感知的局限性
本研究的数据表明,人类在面对高质量AIGC内容时,其视觉和语义的辨别能力已经失效。51%的识别准确率意味着传统的“眼见为实”原则在数字时代已不再适用。AIGC模型(如Midjourney v6, GPT-4)通过海量数据的预训练,已经掌握了人类视觉和语言的深层统计规律。它们生成的不仅是像素或字符的组合,更是符合人类认知预期的“拟像”(Simulacra)。
在视觉上,虽然AI在处理复杂几何拓扑(如多指、错乱的文字)时仍有瑕疵,但普通受众在快速浏览社交媒体时,往往采用“启发式加工”(Heuristic Processing),缺乏足够的认知资源去寻找这些微小的破绽。在语义上,LLM生成的文本往往比普通人类写作更加规范、流畅,这种“过度完美”反而成为了欺骗受众的利器。
6.2 信任悖论:算法厌恶与机器启发式的博弈
医疗信息实验揭示的“标签悖论”是本研究最重要的发现之一。受众在潜意识里偏好AI生成的高质量内容(机器启发式),但在显性认知上却排斥AI的介入(算法厌恶)。这种矛盾源于人类对“信任”本质的理解。
根据来源可信度理论,信任不仅包含对“能力”(Ability/Expertise)的认可,更包含对“善意”(Benevolence)和“正直”(Integrity)的期许。受众承认AI在处理海量数据、提供结构化信息方面具有超越人类的能力;但AI作为一个没有生命、没有情感、无需承担道德和法律责任的算法黑盒,无法向受众传递“善意”和“同理心”。在医疗、法律等高风险(High-stakes)领域,受众需要的不仅是正确的信息,更需要一个能够承担责任的“人”。因此,“AI标签”触发了受众对责任缺失和潜在风险的防御机制,导致信任度骤降。
6.3 跨模态与跨领域的信任差异
研究还发现,受众对AIGC的信任度具有高度的场景依赖性(支持H4)。在编程辅助、数据分析、常规文案撰写等工具性、客观性强的任务中,受众对AIGC的接受度和信任度极高。然而,在涉及人类独特情感、创造力或道德判断的领域(如艺术创作、心理咨询、新闻报道),受众对AIGC表现出强烈的抵触情绪。
例如,在教育领域,学生欢迎AI作为24小时无休的辅导工具,但强烈反对使用逼真的“AI数字人教师”来替代真人教师。受众认为,过度逼真的AI数字人试图“伪装”成人类,这种欺骗感会引发强烈的“恐怖谷”效应,破坏师生之间的情感连接和信任基础。 - 结论与建议
7.1 研究结论
本研究通过多维度的实证分析得出以下核心结论: - 感知界限的模糊:AIGC技术已经发展到人类无法仅凭感官准确区分真伪的阶段。视觉和文本内容的真实感极高,传统的辨伪机制面临失效。
- 标签悖论的存在:受众在实际体验中认可甚至偏好AIGC的高质量输出,但显性的“AI标签”会触发算法厌恶,显著降低信任度。这反映了受众对AI能力认可与对其道德责任缺失担忧之间的深刻矛盾。
- 信任的场景依赖性:AIGC的信任度并非一成不变,而是受到应用场景风险水平、情感需求以及用户自身技术素养的强烈调节。
7.2 实践启示
基于上述结论,本研究为相关利益相关者提出以下建议:
对于政策制定者与监管机构:鉴于人类识别AIGC能力的低下,强制性的“AI生成内容标识”制度(如水印、元数据标签)是维护数字信息生态安全的必要手段。然而,监管不应仅停留在标注层面,更需推动建立AI内容的责任追溯机制,解决受众对AI“无责任主体”的信任危机。
对于科技企业与平台方:在产品设计中应秉持“透明即信任”的原则。虽然短期内AI标签可能降低用户信任,但隐瞒AI身份一旦被识破,将对品牌信誉造成毁灭性打击。企业应致力于提升AI模型的可解释性,让用户理解AI是如何得出结论的,从而将“盲目信任”转化为“知情信任”。
对于教育与公众素养:面对AIGC的泛滥,传统的媒介素养教育必须升级为“AI素养教育”。公众需要了解生成式AI的工作原理、局限性(如幻觉、偏见),学会使用技术手段辅助鉴伪,并培养在人机协同环境下的批判性思维。
7.3 局限性与未来展望
本研究存在一定的局限性。首先,实验中使用的AIGC模型版本(如GPT-4, Midjourney v6)代表了特定时间点的技术水平,随着技术的快速迭代,受众的感知和信任机制可能发生动态演变。其次,生理数据的采集样本量相对有限,未来研究可扩大样本规模,并结合脑电(EEG)或功能性磁共振成像(fMRI)等更深度的神经科学手段,探究受众处理AIGC信息时的底层神经机制。最后,跨文化视角的缺失是本研究的不足,未来可进一步探讨不同文化背景(如集体主义与个人主义)对AIGC信任度的调节作用。
参考文献
[1] Dwivedi, Y. K., Kshetri, N., Hughes, L., et al. (2023). Opinion Paper: “So what if ChatGPT wrote it?” Multidisciplinary perspectives on opportunities, challenges and implications of generative conversational AI for research, practice and policy. International Journal of Information Management, 71, 102642.
[2] Pew Research Center. (2025). Key findings about how Americans view artificial intelligence. Retrieved from https://www.pewresearch.org/short-reads/2026/03/12/key-findings-about-how-americans-view-artificial-intelligence/
[3] Pew Research Center. (2025). Share of U.S. workers using AI on the job is up 5 points since last year. Survey conducted Sept. 2-8, 2025.
[4] Pew Research Center. (2025). How Teens Use and View AI. Survey conducted Sept. 25-Oct. 9, 2025.
[5] Google Developers. (2026). Machine Learning Crash Course: Transformers and Large Language Models. Retrieved from https://developers.google.com/machine-learning/crash-course/llm/transformers
[6] Rombach, R., Blattmann, A., Lorenz, D., Esser, P., & Ommer, B. (2022). High-Resolution Image Synthesis with Latent Diffusion Models. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 10684-10695.
[7] Nightingale, S. J., & Farid, H. (2022). AI-synthesized faces are indistinguishable from real faces and more trustworthy. Proceedings of the National Academy of Sciences, 119(8), e2120481119.
[8] Hovland, C. I., & Weiss, W. (1951). The influence of source credibility on communication effectiveness. Public Opinion Quarterly, 15(4), 635-650.
[9] Logg, J. M., Minson, J. A., & Moore, D. A. (2019). Algorithm aversion: People erroneously avoid algorithms after seeing them err. Journal of Experimental Psychology: General, 148(4), 627-641.
[10] Cooke, D., Edwards, A., Barkoff, S., & Kelly, K. (2024). As Good As A Coin Toss: Human detection of AI-generated images, videos, audio, and audiovisual stimuli. Communications of the ACM.
[11] Liao, Y., & Sundar, S. S. (2022). Designing for Trust: The MATCH Framework for AI-Generated Content. ACM Transactions on Computer-Human Interaction.