1037 Film / 产业与媒介
AIGC生成内容的著作权归属与合理使用边界研究
引言:AIGC浪潮下的版权新范式与核心冲突
核心争议一:生成物(Output)的著作权归属——谁是“作者”?
基本原则:人类作者中心主义的坚守与动摇
归属路径的多元探讨与比较
核心争议二:训练数据(Input)的合理使用——创新与侵权的边界
问题的本质:数据抓取与“合理使用”原则的博弈
司法前沿:全球瞩目的关键诉讼与判决趋势
全球监管框架的比较与借鉴
合规与治理:AIGC时代的版权管理新策略
面向AI开发者的合规路径
面向AIGC使用者的风险防范
内容标识与溯源:迈向可信的AI生态
结论与未来展望
核心观点总结
未来展望
引言:AIGC浪潮下的版权新范式与核心冲突
当前时间坐标定格在2026年,生成式人工智能(AIGC)已经从实验室的极客玩具,彻底演变为重塑全球数字经济底座的基础设施。根据Data Insights Market的报告,全球AIGC解决方案市场在2023年已达到226.5亿美元,并以惊人的32%复合年增长率(CAGR)狂飙突进。从OpenAI的Sora生成逼真的物理世界视频,到Midjourney构建出超越人类想象的视觉奇观,再到ChatGPT在文学、代码和法律文书创作中的深度渗透,AIGC技术正在以前所未有的速度颠覆传统的内容创作行业。
带有抽象艺术处理效果的自然与人工结构融合图像
然而,技术的狂飙不可避免地撞上了传统法律体系的坚墙。过去几年中,我们目睹了史无前例的行业动荡与法律交锋:好莱坞编剧与演员因担忧AI替代和未经授权的数字分身(Digital Replicas)而发起历史性大罢工;AI生成的音乐作品在流媒体平台上以假乱真,引发环球音乐等巨头的联合绞杀;而利用AI生成的艺术画作甚至在人类艺术比赛中拔得头筹,引发了关于“艺术本质”的哲学大讨论。这些现象的背后,隐藏着AIGC与建立在“人类创作者”基础上的传统著作权体系之间的根本性冲突。
在这场由算法驱动的文艺复兴中,法律界、科技界与文化产业界正围绕两大核心议题展开激烈的博弈。本文旨在深度剖析这两大议题,探寻在保护人类创造力与激励技术创新之间的微妙平衡:
输入端(Input)的合法性危机: 现代大语言模型(LLM)和多模态模型的“智能”源于对海量数据的“吞噬”。当这些训练数据中包含数以十亿计的受版权保护的文本、图像和音视频时,未经许可的抓取与训练是否构成侵权?AI公司主张的“合理使用”(Fair Use)边界究竟在哪里?
输出端(Output)的权利真空: 当用户输入一段提示词(Prompt),AI系统在几秒钟内生成一幅精美的画作或一篇深度的文章时,这件生成物(AIGC)的著作权应该归属于谁?是提供意图的用户、编写算法的开发者,还是直接进入公共领域?更进一步,如果生成物与训练数据高度相似,是否构成对原作者的实质性侵权?
核心争议一:生成物(Output)的著作权归属——谁是“作者”?
基本原则:人类作者中心主义的坚守与动摇
自18世纪《安娜女王法令》诞生以来,现代著作权法体系始终建立在两个不可动摇的基石之上:“独创性”(Originality)与“人类作者”(Human Authorship)。版权法保护的是人类思想的个性化表达,是对人类智力劳动的奖赏。然而,AIGC的出现使得“创作”这一行为首次脱离了人类的直接物理控制,机器成为了表达的直接生成者。面对这一挑战,全球司法体系展现出了不同的应对姿态。
美国立场:人类作者的绝对必要原则
美国在AIGC版权归属问题上采取了最为坚决的保守立场,即严格捍卫“人类作者中心主义”。这一立场在2026年3月2日达到了一个具有里程碑意义的节点——美国最高法院正式拒绝审理 Thaler v. Perlmutter 案的上诉。
在该案中,计算机科学家Stephen Thaler试图为其开发的AI系统“创造力机器”(Creativity Machine)自主生成的画作《A Recent Entrance to Paradise》申请版权,并主张AI应被认定为作者,而他作为AI的所有者享有版权。美国版权局(USCO)断然拒绝了该申请。随后,哥伦比亚特区联邦地区法院和联邦上诉法院均支持了版权局的决定。法院在判决中明确指出,尽管《版权法》未对“作者”进行明确定义,但基于宪法和历史判例(如著名的“猴子自拍案” Naruto v. Slater),“人类作者身份是版权的基石要求”。最高法院的拒审,彻底封死了在美国法律框架下承认AI为独立作者的路径。
为了应对日益复杂的AI辅助创作,美国版权局(USCO)发布了详细的指导文件。其核心逻辑在于区分“AI辅助创作”与“纯AI生成创作”。USCO认为,如果AI仅仅是像照相机或Photoshop一样的辅助工具,人类对最终的表达形式拥有“实质性的创造性控制”(Creative Control),那么人类贡献的部分可以获得版权。但如果人类仅仅是提供了一个宽泛的提示词(Prompt),由AI系统决定了作品的最终视觉或文字表达,那么这种输出就如同“向委托画家下达指令”,提示词仅仅是“思想”(Idea),而AI生成的“表达”(Expression)不受版权保护。
中国实践:在“智力投入”与“可控性”中的探索与分歧
与美国相对刚性的标准不同,中国法院在处理AIGC版权纠纷时,展现出了更强的实用主义倾向和对“智力投入”的细致考量。然而,随着案件的积累,中国司法实践也呈现出从初步宽容到逐渐收紧、向国际标准靠拢的演变趋势。
2023年底,北京互联网法院在“李某诉刘某案”(AI生成图片著作权侵权第一案)中,作出了震惊全球版权界的判决。法院认定,原告在使用Stable Diffusion生成图片的过程中,不仅输入了详细的提示词,还不断调整参数、增加反向提示词,进行了多轮迭代。法院认为,这一过程体现了原告的“个性化表达”和“智力投入”,因此该AI生成图片构成美术作品,受著作权法保护。这一判决一度被视为中国对AIGC产业释放的巨大政策红利。
然而,到了2025年3月,江苏省张家港市人民法院在“冯某诉某公司案”中作出了截然不同的判决,首次否认了AI生成图片的著作权。在该案中,原告主张被告生产的椅子侵犯了其使用Midjourney生成的椅子设计图的版权。法院在审理中引入了“可控性”和“可重复性”标准。法院指出,原告承认由于Midjourney算法的随机性,她无法使用相同的提示词再次生成完全相同的图片。法院据此认定,原告对最终的生成结果缺乏实质性的控制,其输入的提示词仅仅是不受保护的“思想”,而非“表达”。此外,原告未能提供充分的“留痕”证据(如迭代过程、参数调整记录)来证明其创造性劳动。因此,法院裁定该图片不构成作品。
对比这两起案件,我们可以清晰地提炼出中国司法裁判的最新趋势:“留痕”与“控制力”成为确权的生死线。 简单的“一键生成”绝无可能获得版权;用户必须保存并证明其在提示词设计、参数微调、局部重绘(Inpainting)、内容筛选与后期修改等环节付出了实质性的、可证明的智力劳动。这一标准实际上正在与美国USCO强调的“创造性控制”标准发生有趣的趋同(Convergence)。
归属路径的多元探讨与比较
既然纯粹的AI不能成为作者,那么在人类与AI深度协同创作的场景下,AIGC的权利究竟该如何分配?法学界和产业界提出了四种主要的归属路径,每一种都伴随着深刻的利弊博弈:
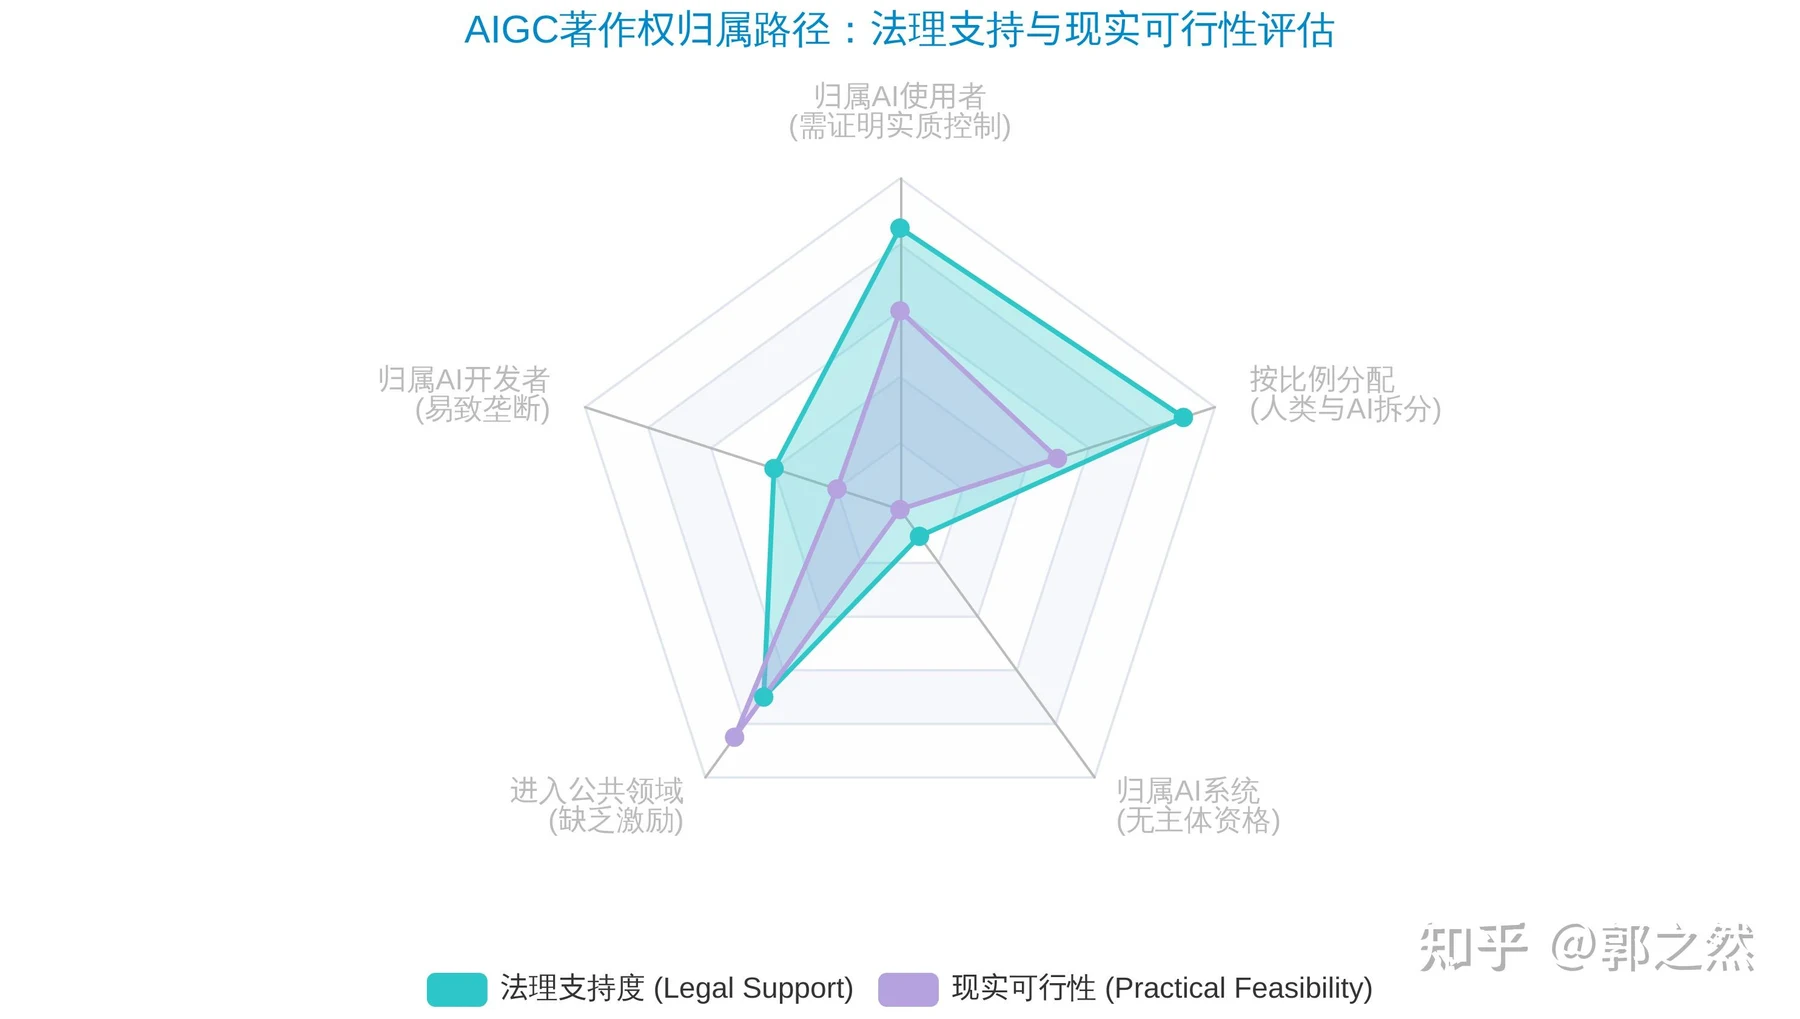
- 归属于AI使用者(用户):
支持理由: 用户是创作的发起者。没有用户的提示词(意图)和不断的引导(反馈),作品根本不会存在。赋予用户版权可以极大激发大众利用AI进行创作的积极性,繁荣文化市场。
面临挑战: 权利与贡献可能不匹配。如果用户只输入了“画一只赛博朋克风格的猫”,AI却生成了极其复杂的细节,将全部版权归属用户,有违“按劳分配”的版权法法理。此外,AI生成的随机性使得用户很难声称对每一个像素拥有“控制权”。 - 归属于AI开发者/服务提供商:
支持理由: 开发者投入了巨额的算力、数据和研发成本,训练出了强大的模型。赋予其一定权利是对其巨额投资的保护。英国《版权、设计和专利法》(CDPA)第9条第3款关于“计算机生成作品”的规定(归属于进行必要安排的人),常被引用为此路径的依据。
面临挑战: 开发者并未参与具体内容的生成,缺乏具体的创作意图。如果将所有生成物的版权归属于OpenAI或Midjourney,将导致极端的垄断,严重剥夺用户的权利,且开发者也无力承担海量生成物可能带来的侵权责任。目前,主流AI平台(如ChatGPT)均在服务条款(ToS)中明确放弃对生成物主张权利,将其转让给用户。 - 进入公共领域(Public Domain):
支持理由: 既然AIGC缺乏足够的人类独创性,不符合传统作品的构成要件,那么它就应该像自然风光或客观事实一样,直接进入公共领域,允许任何人自由使用。这有助于知识的无障碍传播,降低全社会的创作成本。
面临挑战: 这种“一刀切”的做法可能产生“公地悲剧”。如果企业利用AI辅助制作了一部耗资巨大的动画电影,却因为包含大量AI元素而无法获得版权保护,将彻底摧毁商业投资的逻辑。缺乏排他性权利的保护,复杂的AI协同创作将失去经济激励。 - 归属于AI系统本身(赋予电子人格):
支持理由: 承认AI在事实上的创作能力,赋予其有限的法律主体地位,设立专门的基金或信托来管理其版权收益。
面临挑战: 这一路径在现行法律框架下完全行不通。AI没有意识,无法承担民事责任,也无法享受经济激励(AI不需要钱来激发创作欲望)。正如前文所述,美国最高法院在 Thaler 案中已彻底否决了这一可能。
综上所述,目前的全球共识正逐渐收敛于一种“按比例分配的实用主义”:剥离纯AI生成的部分(进入公共领域),仅对人类用户施加了实质性控制和修改的部分(如独特的排版、深度的后期编辑)给予版权保护。这要求未来的版权登记系统必须具备拆解“人类贡献”与“机器贡献”的能力。
核心争议二:训练数据(Input)的合理使用——创新与侵权的边界
问题的本质:数据抓取与“合理使用”原则的博弈
如果说输出端的争议关乎“谁摘取果实”,那么输入端的争议则直击AIGC产业的命门——“谁拥有土壤”。现代生成式AI(如GPT-4、Claude 3、Sora)的强大能力,建立在对互联网上数以万亿计的Token(文本片段)、图像和视频的“预训练”(Pre-training)基础之上。这些数据中,包含了海量受版权保护的新闻报道、小说、画作和代码。
AI公司普遍主张,模型在训练过程中并非“复制”或“存储”了原作品,而是通过分析数据提取了语言规律、统计模式和概念特征(即权重参数)。他们将这种行为类比为“人类阅读书籍后学会了写作”,并以此为由,援引美国版权法中的“合理使用”(Fair Use)原则,或欧盟的“文本与数据挖掘”(Text and Data Mining, TDM)例外条款进行抗辩。然而,版权方(作家、媒体、艺术家)则愤怒地指出,这是人类历史上最大规模的“知识产权盗窃”,AI公司利用他们的心血训练出了直接替代他们工作的商业产品。
司法前沿:全球瞩目的关键诉讼与判决趋势
进入2025年和2026年,美国法院开始对第一批AI训练侵权案件作出实质性裁决。这些判决不仅没有平息争议,反而揭示了司法界在适用“合理使用”原则时的深刻分歧。
| Data Source: Industry Estimates 2024-2026 |
|---|
1. “转换性使用”的普遍认可与市场损害的分歧
在评估合理使用的四个要素时,第一要素(使用的目的和性质)和第四要素(对潜在市场的影响)最为关键。在2025年6月的两个标志性案件中,法官们对第一要素达成了共识,但在第四要素上产生了严重分歧。
在 Bartz v. Anthropic 案中,法官认为Anthropic使用受版权保护的书籍训练Claude模型是“极其惊人的转换性使用”(spectacularly transformative)。法官指出,训练过程是为了让模型学习语言,而不是为了向用户展示原书内容。在市场损害方面,法官认为Claude并不会直接输出原书的精确副本,因此不会替代原书的销售市场。法官甚至比喻道:“原告的抱怨,就像是抱怨教小学生写好作文会导致市场上出现大量竞争作品一样。”
仅仅两天后,在 Kadrey v. Meta 案中,另一位法官同样认定Meta训练Llama模型具有高度转换性。然而,该法官严厉批评了原告在证明“市场损害”方面的软弱,但同时指出,如果原告能够证明“市场稀释理论”(Market Dilution Theory)——即AI模型泛滥导致人类原创作品的整体市场价值下降,那么合理使用的抗辩可能会被推翻。这为未来的诉讼留下了巨大的悬念。
2. 数据来源的合法性:不可逾越的红线
尽管法院倾向于认为“训练”本身是合理使用,但获取训练数据的“手段”却成为了AI公司的阿喀琉斯之踵。在 Bartz v. Anthropic 案中,原告指控Anthropic从臭名昭著的“影子图书馆”(如LibGen,包含大量盗版电子书)下载了数百万本书用于训练。法官明确裁定:即使最终的训练目的是合理使用,但非法获取并存储盗版书籍的行为本身绝不构成合理使用。 这一裁决犹如一颗重磅炸弹,直接导致Anthropic面临潜在的数千亿美元法定赔偿风险。最终,Anthropic在2025年底被迫以15亿美元的天价与原告达成和解,并承诺销毁盗版数据集。
3. 非生成式AI与直接竞争者的区分
并非所有AI都能披上“转换性使用”的外衣。在2025年2月的 Thomson Reuters v. Ross Intelligence 案中,法院裁定Ross使用汤森路透Westlaw的受版权保护的法律头注(Headnotes)来训练其AI法律检索工具不构成合理使用。法官强调,Ross的工具不是生成式AI(它不写备忘录),而是一个直接与Westlaw竞争的检索工具。这种直接的“市场替代性”彻底摧毁了合理使用的基础。
小结:从“全面战争”走向“授权许可”的新常态
面对动辄数十亿美元的诉讼风险和不确定的司法裁判,AI巨头们的策略在2025-2026年发生了根本性转变。行业正从“先抓取,后道歉”的野蛮生长,转向“花钱买平安”的授权模式。2025年底,环球音乐(UMG)和华纳音乐(WMG)与AI音乐生成平台Udio和Suno达成和解并签署授权协议;2026年初,迪士尼宣布向OpenAI投资10亿美元,授权其Sora模型使用迪士尼的经典IP进行训练和生成。这些标志性事件表明,“授权许可”(Licensing)正在取代“合理使用”,成为解决输入端版权争议的主流商业路径。
全球监管框架的比较与借鉴
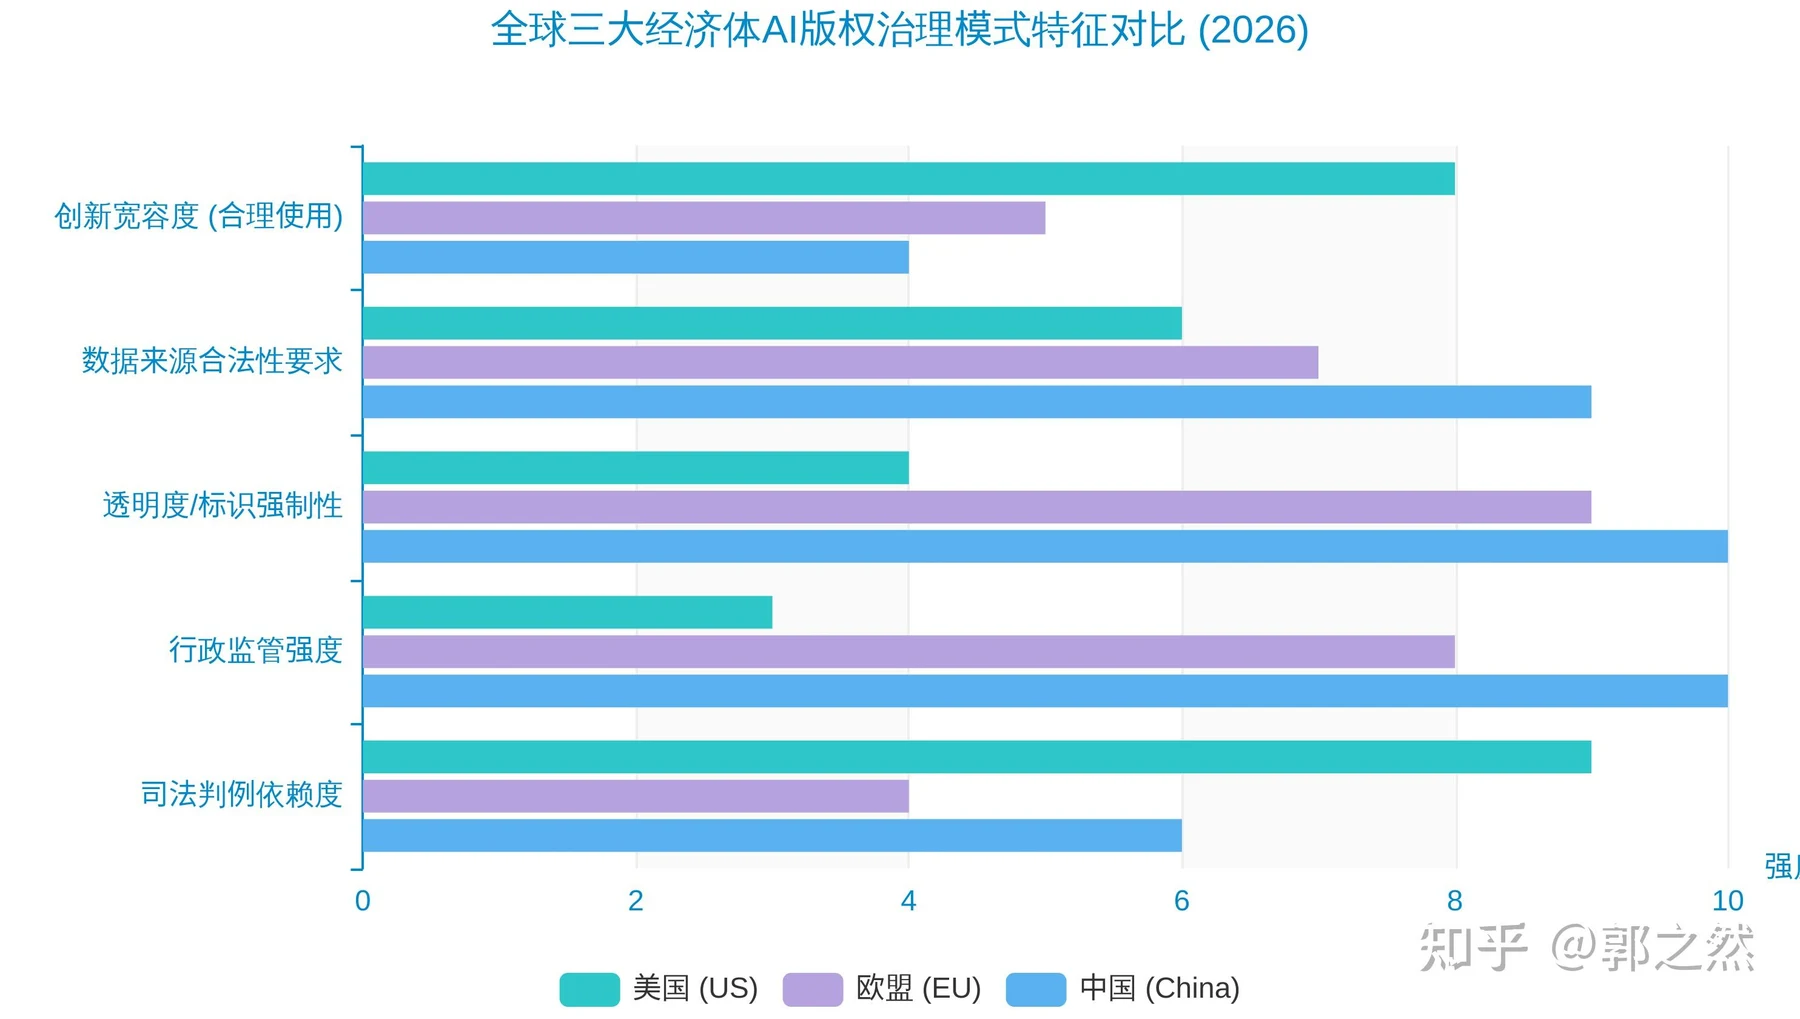
在司法系统艰难摸索的同时,各国立法机构已经开始通过成文法对AI训练数据进行规制,形成了三种截然不同的治理模式:
欧盟:风险分级与透明度优先(《AI法案》)
欧盟《AI法案》(EU AI Act)于2024年生效,其关于通用人工智能(GPAI)的规定在2025年8月开始适用,并将在2026年8月全面强制执行。欧盟采取了“文本与数据挖掘(TDM)例外 + 权利人选择退出(Opt-out)”的精巧平衡。根据《数字单一市场版权指令》(DSM),AI公司可以进行数据挖掘,但前提是权利人没有通过机器可读的方式(如网站协议中的特定代码)明确声明保留权利。更重要的是,《AI法案》第53条强制要求GPAI提供商必须公开用于训练模型的数据摘要。这种极高的透明度要求,使得版权方能够轻易发现自己的作品是否被用于训练,从而为后续的维权或授权谈判提供了弹药。
中国:合法性底线与强力行政监管
中国的监管思路体现了对数据安全和意识形态的高度重视。2023年施行的《生成式人工智能服务管理暂行办法》明确规定,训练数据必须具有“合法来源”,不得侵害他人依法享有的知识产权。与欧美的司法事后救济不同,中国采取了严格的“事前/事中监管”模式,包括算法备案制度和安全评估。这意味着,如果AI模型被发现使用了大量侵权数据,不仅面临民事诉讼,更可能面临网信办等监管部门的行政处罚甚至下架风险。
日本与英国:在“亲创新”与“护版权”间摇摆
日本在2018年修订的版权法第30条之4被认为是全球对AI最友好的条款之一。它允许在不以“个人欣赏”为目的的情况下,为数据分析(包括AI训练)使用受版权保护的作品。然而,随着AIGC的爆发,日本文化厅在2024年发布指南,明确如果训练的目的是为了生成与原作品高度相似的内容(即存在替代市场风险),则不适用该例外。英国政府曾一度提议引入极其宽泛的TDM例外以打造“全球AI中心”,但在创意产业的强烈抗议下被迫搁置,目前仍在艰难寻找平衡点。
合规与治理:AIGC时代的版权管理新策略
在法律边界逐渐清晰、监管大网日益收紧的2026年,无论是AI大模型的开发者,还是使用AIGC工具的创作者和企业,都必须建立一套全新的版权合规与治理策略。
面向AI开发者的合规路径
对于AI企业而言,“数据即原罪”的时代已经结束,构建合法、合规的数据供应链是生存的前提:
- 数据来源的彻底净化: 必须立即停止使用“影子图书馆”(如LibGen、Z-Library)或未经授权的BT种子下载盗版内容进行训练。Bartz v. Anthropic 案的15亿美元教训表明,非法获取数据的行为本身就是一颗定时炸弹。开发者应优先使用公共领域数据、开源数据集(需严格审查其开源协议是否允许商业训练),或自建高质量的合成数据(Synthetic Data)。
- 全面拥抱授权生态: 建立专门的数据采购团队,与新闻集团、图片库(如Getty Images、Shutterstock)、学术出版商和音乐版权代理机构建立战略合作。探索多元化的商业模式,如一次性买断、按API调用次数分成,或建立类似音乐行业的“集体管理组织”(CMO)进行统一定价和授权。
- 技术透明与“机器遗忘”: 严格遵守欧盟《AI法案》的要求,建立完善的版权政策,并对外发布详尽的训练数据摘要。同时,必须开发可靠的技术工具,以识别并尊重网站的“Opt-out”协议(如robots.txt中的AI爬虫屏蔽指令)。更具挑战性的是,开发者需要投资研发“机器遗忘”(Machine Unlearning)技术——当权利人要求删除其数据或法院判定侵权时,模型能够在不完全重新训练的情况下,精准剔除特定数据的影响。
面向AIGC使用者的风险防范
对于广告公司、设计师、自媒体等AIGC的高频使用者,必须摒弃“AI生成即免费”的危险错觉:
警惕“实质性相似”陷阱: 即使使用了合法的AI工具,如果生成的输出物与现有的知名IP(如米老鼠、超级马里奥)或特定艺术家的独特风格高度相似,直接用于商业变现依然会构成传统的版权侵权或不正当竞争。
建立严密的“创作留痕”制度: 鉴于中美等国法院均要求证明“人类创造性控制”,使用者若想对AI辅助生成的作品主张版权,必须建立标准化的SOP(标准作业程序)。这包括:保存初始的构思草图;记录完整、多轮迭代的提示词(Prompts)演变;保留参数调整、局部重绘(Inpainting)的中间过程截图;以及最终使用Photoshop等传统工具进行实质性修改的工程文件。这些“留痕”是未来在法庭上证明“智力投入”的唯一凭证。
审查平台服务协议(ToS): 不同的AI平台对生成物的权利主张截然不同。企业在使用前必须由法务部门审查ToS,确认平台是否授予了生成物的商业使用权,平台是否承诺对生成物侵权提供知识产权赔偿(IP Indemnity,如微软Copilot和Adobe Firefly提供的护城河条款)。
内容标识与溯源:迈向可信的AI生态
在版权归属和合理使用之外,如何区分“人类创作”与“AI生成”,防止虚假信息泛滥,成为了全球监管的另一大共识。内容标识(Labeling)与水印(Watermarking)技术正在成为AIGC行业的强制性标准。
中国在这方面走在了世界前列。2025年9月生效的,构建了全球最严格的“全链条”标识制度。该办法不仅要求大模型提供商在生成的图片、视频中添加肉眼可见的“显式标识”,还强制要求在文件元数据中植入不可篡改的“隐式标识”。更严厉的是,这种标识义务不仅约束生成端,还延伸到了分发、传播和使用的各个环节,要求社交平台和媒体在检测到AIGC内容时必须向公众进行显著提示。
欧盟《AI法案》第50条同样规定了透明度义务,要求部署者在生成“深度伪造”(Deepfake)或具有公共利益影响的文本时,必须披露内容是由AI生成的。目前,欧盟正在起草,预计于2026年中期定稿,该准则将推动行业采用统一的机器可读标记标准。
在技术层面,以C2PA(内容来源和真实性联盟)为代表的国际标准正在被广泛采纳。C2PA通过密码学技术,将内容的来源信息(谁创建的、使用了什么AI工具、进行了哪些修改)安全地绑定在数字文件中,形成数字内容的“营养成分表”。这种溯源技术不仅有助于打击假新闻,也为未来AIGC版权的精确确权和收益分配提供了技术基础设施。
结论与未来展望
核心观点总结
站在2026年的时间节点上,回顾AIGC与著作权法的激烈碰撞,我们可以得出以下核心结论:
- 在输出端(所有权),“人类中心主义”依然是全球版权体系的底色。 纯粹由AI自动生成的内容被坚决排除在版权保护之外。然而,法律并未对AI关上大门,而是将审查的焦点转移到了“人类创造性控制”的程度上。通过精细的提示词设计、参数控制和后期修改,人类与AI的“协同创作”完全可以获得版权保护,前提是创作者必须承担起沉重的“留痕”与举证责任。
- 在输入端(合理使用),“先上车后补票”的野蛮时代宣告终结。 尽管多国法院在一定程度上认可了AI训练的“转换性”特征,但数据来源的合法性已成为不可逾越的红线。面对天价的侵权赔偿风险,AI巨头们正加速向“授权许可”模式妥协。版权数据正在从免费的“公共资源”,转变为具有明确定价的“战略资产”。
- 在治理框架上,全球呈现出“殊途同归”的趋势。 尽管美国依赖司法判例、欧盟依靠风险分级立法、中国依托强力行政监管,但各国在要求AI提高透明度、尊重版权人Opt-out权利、以及强制实施内容标识(水印)方面,正在形成高度的国际共识。
未来展望
AIGC对版权体系的冲击,绝非修修补补所能平息,它预示着一场深刻的制度与商业模式重构:
首先,法律体系将面临结构性演进。 现有的著作权法在应对AI时显得捉襟见肘。未来,立法者可能会探索设立一种专门针对AI生成物的“邻接权”(Neighboring Rights)或“特殊权利”(Sui Generis Right),给予其较短的保护期(如5-10年),以平衡投资激励与公共利益。同时,针对AI模仿特定艺术家风格(Style)或声音(Voice)的行为,传统的版权法难以规制,未来可能会通过强化“公开权”(Right of Publicity)或反不正当竞争法来提供救济。
其次,技术将成为解决法律问题的关键。 面对海量的数据和确权难题,传统的法律诉讼成本过高。未来,基于区块链的智能合约、C2PA溯源技术以及自动化的微支付(Micro-payment)系统,将构建起一个全新的数字版权基础设施。当AI模型生成一段音乐时,系统能够自动追踪其使用了哪些艺术家的训练数据,并实时、按比例地将收益分配给原作者。
最后,创作者的价值将被重新定义。 在AIGC时代,平庸的、套路化的内容生产将被机器彻底取代。人类创作者的核心竞争力,将不再是熟练掌握某种绘画技巧或写作格式,而是转移到独特的审美判断、深刻的情感共鸣、复杂的叙事架构以及对AI工具的卓越“指挥”能力上。版权法保护的,将越来越少是“劳动的汗水”,而越来越多是“灵魂的火花”。在这个由硅基智能与碳基智慧共同编织的新纪元里,版权法不仅是保护创新的盾牌,更是指引人类文明向更高阶创造力进化的灯塔。
参考资料
[1]
An update on AI copyright cases in 2026 | Global law firm
[2]
Out of the Shadow Library: Fair Use and AI Training Data
https://www.bakerbotts.com/thought-leadership/publications/2026/february/out-of-the-shadow-library
[3]
The Final Word? Supreme Court Refuses to Hear Case on ...
[4]
Beijing Internet Court Requires Evidence of Creative Effort ...
[5]
Federal Court Sides with Plaintiff in the First Major AI ...
https://www.jw.com/news/insights-federal-court-ai-copyright-decision/
[6]
An update on AI copyright cases in 2026 | Global law firm
[7]
AI Regulation Global Framework 2026: How EU, US, and ...
[8]
China: Copyright Protection for AI-Generated Content
https://mmlcgroup.com/china-copyright-ai-gen/
[9]
Out of the Shadow Library: Fair Use and AI Training Data
https://www.bakerbotts.com/thought-leadership/publications/2026/february/out-of-the-shadow-library
[10]
AI labeling requirement starting in 2026: What you need to know
https://weventure.de/en/blog/ai-labeling
[11]
Copyright Conundrum: Examining AI-Generated Content ...
[12]
AI, Authorship, and Copyright: A Comparison Between the ...
[13]
Artificial Intelligence and Intellectual Property
https://www.wipo.int/en/web/frontier-technologies/artificial-intelligence/index
[14]
(PDF) Copyright Issues and Innovation Incentives in AI-Generated ...
[15]
AI Compliance Frontline: A Deep Dive into AIGC Labeling - Lexology
https://www.lexology.com/library/detail.aspx?g=b427f897-efdd-481d-90ca-a8fabf57ba87
[16]
Code of Practice on marking and labelling of AI-generated ...
https://digital-strategy.ec.europa.eu/en/policies/code-practice-ai-generated-content
[17]
US Supreme Court declines to hear dispute over ...
[18]
Chinese Court Found AI-Generated Pictures Not ...
[19]
AI Copyright Lawsuit Developments in 2025: A Year in Review
https://copyrightalliance.org/ai-copyright-lawsuit-developments-2025/
[20]
Copyright Law in 2025: Courts begin to draw lines around AI training ...
[21]
Disney Swaps Lawsuits for Licenses in $1B OpenAI Deal
https://www.spellbook.legal/newsletter/inside-disneys-1b-openai-deal
[22]
Emerging Market Insights in AIGC Solutions: 2026-2034 Overview
https://www.datainsightsmarket.com/reports/aigc-solutions-1390580