1037 Film / 产业与媒介
AI配音与虚拟演员:情感的“幻觉”与观众的“共情”—— 一场技术与心理的深度博弈
目录
引言:2026,AI声音的“寒武纪”与“真实性”大考
技术前沿:AI如何“学习”情感的腔调?
核心技术概览
技术应用的广度
核心挑战:AI情感表达的“失真”与“貌合神离”
“几乎正确”的陷阱:难以逾越的“恐怖谷”
“人话”与“合成话”的鸿沟:语音分布的根本差异
文化与情境的“盲区”:情感表达的失焦
观众的判决:接受、信任还是疏离?
接受度的双重标准:自然度(Naturalness)与相似度(Similarity)
信任的建立与瓦解:从认知到情感的跨越
虚拟角色的情感纽带:拟社会关系(Parasocial Relationships)的形成与挑战
弥合鸿沟:人机协同与伦理护航
“人在环路”(Human-in-the-Loop, HITL):从自动化到增强智能
伦理与法规的“紧箍咒”:构建负责任的AI声音生态
总结与展望:走向“共情智能”的未来
引言:2026,AI声音的“寒武纪”与“真实性”大考
时间来到2026年,人工智能语音技术正经历一场前所未有的“寒武纪大爆发”。根据市场预测,全球AI语音实验室市场规模预计将从2025年的40.2亿美元激增至2026年的51.7亿美元,并有望在2035年达到惊人的501.6亿美元,复合年增长率(CAGR)高达28.71% Precedence Research。在企业端,超过97%的组织已经采用了某种形式的语音技术,包括语音识别和转录工具 Jesty CRM。AI语音不再仅仅是实验室里的极客玩具,它已经深刻地嵌入到影视制作、游戏开发、广告营销以及客户服务等内容产业的骨髓中,成为重塑行业格局的核心力量。
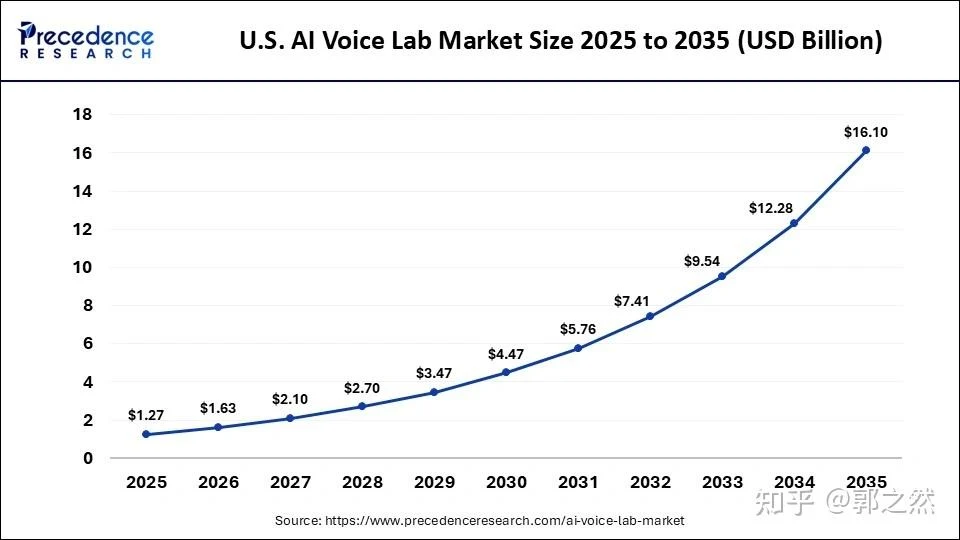
美国AI语音实验室市场规模2025至2035年预测
然而,在这场狂飙突进的技术革命中,一个核心矛盾日益凸显:技术在追求“无限逼真”的道路上,遭遇了人类情感表达的“最后壁垒”。一方面,AI展现出了令人咋舌的效率和成本优势。在视频本地化(AI Dubbing)领域,AI配音能够将成本降低高达90%,并将制作周期从数月压缩至短短几天 RWS。另一方面,作为内容消费者的人类,对“有灵魂”的情感连接需求却在日益增长。当面对那些虽然字正腔圆但却缺乏真实情感波动的“空洞”AI声音时,观众往往会产生本能的心理抗拒。这种抗拒不仅源于听觉上的不适,更深层地反映了人类对真实情感共鸣的渴望。
本文将深入探讨这一技术与心理交织的复杂博弈,聚焦两大核心议题:首先,**情感表达的边界**。我们将剖析当前AI语音技术在模拟人类情感方面究竟取得了哪些突破,同时揭示其技术瓶颈与“情感失真”的深层根源。其次,**观众接受的密码**。我们将探究观众对AI声音的接受度受哪些心理因素影响,以及在何种情境下,人们愿意跨越“恐怖谷”,信任并与AI虚拟角色建立起真实的情感连接。
通过剖析技术前沿、核心挑战、观众心理以及伦理规范四大维度,本文旨在揭示AI配音与虚拟演员在走向“情感真实”之路上,技术与人性之间那场深刻而复杂的博弈。
技术前沿:AI如何“学习”情感的腔调?
核心技术概览
要理解AI声音的现状,首先需要了解驱动其情感表达的关键技术。近年来,语音合成(Text-to-Speech, TTS)技术经历了从拼接合成(Concatenative TTS)到参数合成(Parametric TTS),再到如今基于深度学习的神经语音合成(Neural TTS)的跨越式发展。这些技术的进步,使得AI在模拟人类声音的音色和韵律方面取得了长足的进步。
首当其冲的是**语音克隆技术(Voice Cloning)**。过去,克隆一个人的声音需要数小时甚至数天的高质量录音数据。而现在,借助“零样本/少样本”(Zero-Shot/Few-Shot)学习技术,AI仅需短短几秒钟的音频样本,就能高度还原目标说话人的音色(Timbre)和基本说话风格。例如,一些先进的模型(如VITS、NaturalSpeech 2等)能够在极短的时间内捕捉到声音的独特纹理,这极大地提高了语音生成的效率和灵活性 Voice Cloning Survey。
然而,仅仅模仿音色是不够的,真正的情感表达在于**情感韵律控制(Prosody Control)**。韵律包含了音高(Pitch)、能量(Energy)、时长(Duration)等多个维度的变化,是传递情感和语气的关键。现代TTS系统正试图超越简单的文本朗读,通过引入更精细的控制机制来实现情感的动态变化。例如,一些研究采用了“唤醒度-效价(Arousal-Valence)”二维情感模型,允许用户在连续的空间内调节生成语音的情感强度和正负向,从而实现比离散情感标签(如“高兴”、“悲伤”)更细腻、更具解释性的情感控制 EmoVoice。
此外,**大型语言模型(LLM)驱动的上下文理解**为AI语音注入了“灵魂”。传统的TTS系统往往只关注当前句子的文本,而忽略了对话的上下文语境。随着LLM的融入,TTS系统能够更好地理解文本背后的语义逻辑、说话人的意图以及对话的情境,从而生成更符合语境的情感表达。这是AI语音从“字正腔圆”的机械朗读向“声情并茂”的自然交流迈出的关键一步 Emotion-aware Conversational TTS。
技术应用的广度
这些技术的突破,使得AI语音在多个领域展现出巨大的商业价值和渗透力。
**内容本地化(AI Dubbing)**:AI配音正在颠覆传统的影视和视频本地化行业。通过结合语音识别、机器翻译和语音克隆技术,AI能够快速生成多语种的配音轨道,同时保留原说话人的音色和语调。这不仅大幅降低了成本和周期,还使得创作者和企业能够以前所未有的速度将内容推向全球市场 RWS。
**游戏产业(Gaming)**:在游戏领域,AI语音为非玩家角色(NPC)注入了新的生命力。传统的游戏开发往往受限于配音成本,NPC的对话通常是预先录制且有限的。而现在,借助生成式AI,NPC可以根据玩家的互动实时生成动态的、带有情感的语音回应,极大地增强了游戏的沉浸感和真实感 Forbes。
**虚拟代理人(Virtual Agents)**:在客户服务、虚拟伴侣、数字人等领域,AI语音正在提供更具“人情味”的交互体验。现代的语音代理不仅能回答问题,还能检测用户的情绪状态,并以相应的同理心进行回应,从而在多轮对话中维持更自然、更连贯的交流 NextLevel.AI。
| 关键要点AI语音技术已从简单的文本朗读进化到具备零样本克隆、精细韵律控制和LLM上下文理解的高级阶段。这些技术突破极大地提升了内容本地化、游戏NPC交互和虚拟代理人服务的效率与沉浸感。 |
|---|
核心挑战:AI情感表达的“失真”与“貌合神离”
尽管AI语音技术在效率和音色还原上取得了令人瞩目的成就,但在模拟人类真实情感表达方面,仍面临着难以逾越的鸿沟。这种“失真”不仅是技术上的瑕疵,更是AI与人类在情感认知机制上的本质差异。
“几乎正确”的陷阱:难以逾越的“恐怖谷”
在听觉体验上,AI声音常常陷入一种“听起来对,但感觉不对”的尴尬境地。这种现象可以被视为听觉领域的“恐怖谷”效应。具体而言,AI合成的语音在语法和发音上可能完美无缺,但在情感的传递上却显得生硬和机械。正如行业专家所言:“AI能复制音符,但常错过音乐。” RWS
这种“失真”表现在多个层面:首先是**韵律的平淡**。人类在表达强烈情感时,音高、语速和音量会发生剧烈而自然的波动,而AI往往难以捕捉这种动态范围,导致声音听起来单调乏味。其次是**情感转折的生硬**。在复杂的对话中,人类的情感会随着语境的微妙变化而自然过渡,而AI在处理这种情感转换时往往显得突兀,缺乏连贯性。最关键的是,AI**缺乏微表情**。人类的语音中充满了叹息、轻笑、声音的微颤等非语言线索,这些微小的细节是传递真实情感的关键,而目前的AI模型很难自然地生成这些元素。
究其原因,AI的情感生成本质上是一种基于海量数据的“统计学模仿”,而非基于真实理解与体验的“有机表达”。人类的发声是一个复杂的生理与心理联动过程,受到情绪状态、身体反应、甚至潜意识的共同影响。而AI只是在数学模型中寻找文本与声学特征之间的映射关系,它并不“感受”悲伤或喜悦,只是在“计算”悲伤或喜悦的声学参数。这种缺乏内在情感驱动的模仿,注定难以触及人类情感的灵魂深处。
“人话”与“合成话”的鸿沟:语音分布的根本差异
更深层次的挑战在于,AI合成语音与人类真实语音在声学特征分布上存在着根本的差异。一项近期的研究(arXiv:2603.16483)揭示了一个令人深思的现象:在人类语音数据集上训练出来的情感识别(SER)模型,在识别AI合成语音的情感时,表现出了灾难性的性能下降 Emotion Understanding in Synthesized Speech。
这证明了人类语音与AI合成语音之间存在着一条难以跨越的“分布鸿沟”(Distribution Gap)。即使AI合成的语音在内容和情感标签上与人类语音完全一致,其生成过程也不可避免地产生了一些人类听觉系统能够敏锐捕捉到,但AI模型难以克服的非自然“痕迹”。
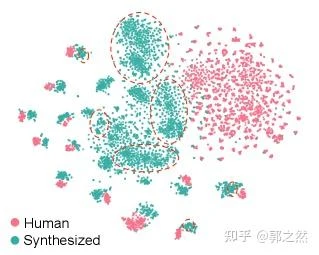
人类语音与AI合成语音在特征空间中的分布差异
此外,该研究还指出了当前语音大语言模型(Speech LLMs)存在严重的“文本霸权”(Text Dominance)现象。当这些模型试图理解语音中的情感时,它们过度依赖于文本的语义内容,而忽略了声音本身的副语言线索(Paralinguistic Cues)。例如,如果一个人用极其悲伤的语调说出“我很高兴”,人类听众能立刻察觉到其中的反讽或言不由衷,但当前的语音LLM往往会仅仅根据文本内容将其判定为“高兴”。这种对文本语义的过度依赖,使得AI在处理复杂、微妙或与字面意思不符的情感表达时显得无能为力。
为了更直观地展示这一问题,我们可以观察AI合成语音在情感分类任务中的混淆矩阵。数据显示,即使是顶尖的商业模型生成的合成语音,在被情感识别模型评估时,也存在大量的误判。特别是,许多带有明确情感倾向的语音被错误地归类为“中性”(Neutral),这进一步印证了AI合成语音在情感表达上的模糊性和不确定性。
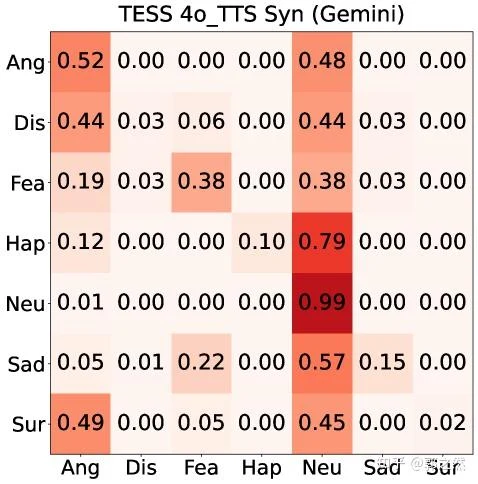
AI合成语音情感分类混淆矩阵:大量情感被误判为“中性”
文化与情境的“盲区”:情感表达的失焦
除了声学特征上的缺陷,AI在情感表达上还面临着文化与情境理解的巨大盲区。情感的表达和感知深深植根于特定的文化背景和社会语境中。一个在某种文化中被视为幽默的玩笑,在另一种文化中可能显得莫名其妙甚至具有冒犯性。目前的机器翻译和语音合成系统虽然在语法和发音上越来越准确,但往往难以捕捉和再现这些复杂的文化潜台词、习语和社交暗示 RWS。
在动态交互场景中,这种局限性表现得尤为明显。人类在面对面交流时,会根据对方的微小反馈(如眼神、表情、肢体语言)实时调整自己的语气和情感表达。而AI的反应往往是基于预设算法的、单向的输出,缺乏这种自发的、动态的调整能力。这导致AI在实时对话中往往显得反应迟钝、缺乏“在场感”和“流动感”,难以与人类建立起真正的情感共鸣。
| 关键要点AI情感表达受困于“恐怖谷”,表现为韵律平淡、缺乏微表情,本质是“统计模仿”而非“有机表达”。人类语音与合成语音存在根本的分布差异,且AI模型存在“文本霸权”,难以理解副语言线索。AI在跨文化语境和动态交互中缺乏适应性,导致情感表达失焦。 |
|---|
观众的判决:接受、信任还是疏离?
技术的发展最终要接受市场的检验,而观众的心理反应是决定AI配音和虚拟演员命运的关键。观众对AI声音的接受度并非单一维度的考量,而是一个涉及感知、认知和情感的复杂心理过程。
接受度的双重标准:自然度(Naturalness)与相似度(Similarity)
研究表明,观众在评价AI声音时,主要基于两个核心维度:自然度(Naturalness)和相似度(Similarity)。
首先是**自然度**,即声音听起来是否像一个“真正的人”在说话。这不仅关乎发音的准确性,更取决于韵律、停顿、语调的自然流畅度。一项使用MUSHRA(Multiple Stimuli with Hidden Reference and Anchor)测试的感知实验表明,即使是当前最顶尖的商业AI语音模型(如ElevenLabs),也仅仅在短句测试中勉强接近人类的自然度水平。更重要的是,实验发现,当人为减少真实人类语音的基频(F0)变异(即让语调变得平淡)时,其自然度评分会显著下降,甚至与表现较差的AI模型相当 Perception of AI-Voice Clones。这充分说明,观众的耳朵对韵律的微小不自然极其敏感,技术上的“高保真”并不等同于感知上的“高自然度”。
其次是**相似度**,即克隆的声音是否与原声(Target Speaker)足够相似。这不仅仅是音色特征的匹配,更包含了说话人的独特风格、口音和习惯的还原。研究发现,观众对相似度的评价会受到自身语言背景和模型训练数据偏差的影响。例如,主要在美式英语数据集上训练的模型,在克隆英式英语口音时,其相似度评分会显著降低。这表明,观众在评判AI声音时,会不自觉地代入自身的文化和语言经验。
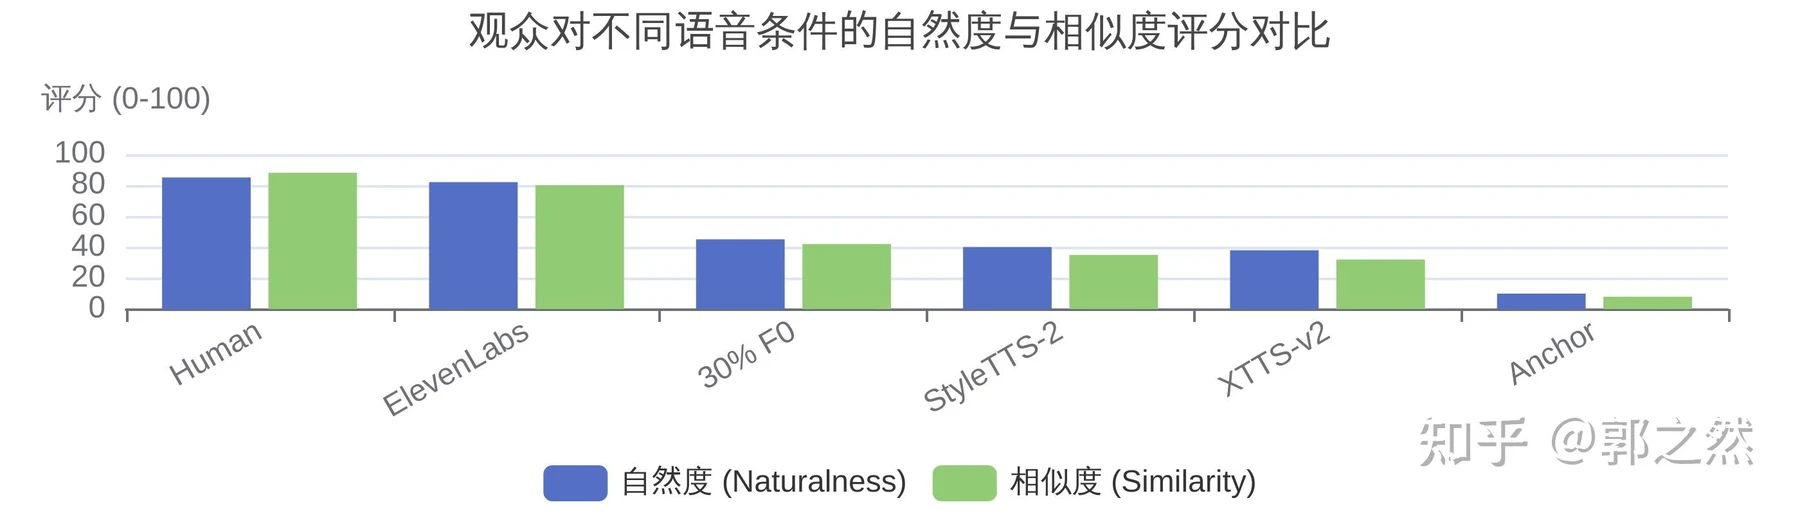
信任的建立与瓦解:从认知到情感的跨越
在接受度的基础上,更深层次的挑战在于如何建立观众对AI的信任。一项基于启发式-系统性模型(Heuristic-Systematic Model, HSM)的研究提出,用户对AI代理的信任可以分为两个维度:认知信任(Cognitive Trust)和情感信任(Affective Trust) Trust in AI Agents。
**认知信任**是基于对AI能力的理性评估。当观众认为AI配音发音清晰、信息准确、能够有效完成任务(如提供清晰的旁白或翻译)时,就会产生认知信任。这种信任主要由AI的“感知惠益”(Perceived Benefit)和用户的“感知知识”(Perceived Knowledge)驱动。在许多工具性场景(如新闻播报、有声书朗读)中,认知信任往往足以支撑用户的基本接受度。
然而,在影视、游戏等强调情感共鸣的内容领域,仅有认知信任是远远不够的。观众需要建立**情感信任**,这基于与AI交互过程中的情感联结和心理舒适度。情感信任主要由交互的“感知愉悦度”(Perceived Pleasure)和AI的“拟人化程度”(Anthropomorphism)驱动。当AI声音陷入“恐怖谷”,表现出机械、冷漠或不合时宜的情感时,观众的心理防线就会被触发,情感信任瞬间瓦解。因此,AI配音和虚拟演员若要被真正接受,必须通过提升行为真实感(Behavioral Realism)来跨越从认知到情感的信任鸿沟。
虚拟角色的情感纽带:拟社会关系(Parasocial Relationships)的形成与挑战
在社交媒体和虚拟娱乐时代,观众与媒体角色(包括虚拟演员和虚拟网红)之间往往会形成一种单向的、类似真实朋友的情感联系,心理学上称之为“拟社会关系”(Parasocial Relationships)。这种关系的深度直接影响着用户的粘性、忠诚度甚至购买意愿 Parasocial Relationships in Social Media。
然而,AI虚拟角色的出现为拟社会关系的建立带来了新的挑战。首先,**“恐怖谷”效应**依然是最大的绊脚石。过于逼真但又在微表情或声音韵律上存在瑕疵的虚拟形象,会引发观众的心理不适,阻碍情感的代入。其次,**自主性的模糊**也会影响信任的建立。观众往往不清楚虚拟角色背后的行为是完全由AI自主生成,还是有人类团队在幕后操控。这种认知上的模糊性会削弱虚拟角色的真实感,进而影响拟社会关系的深度 Virtual Influencers and Parasocial Relationships。
更有趣的是,观众自身的心理特质也会显著影响他们对AI虚拟角色的偏好。一项关于孤独感与虚拟代理人使用的研究揭示了一个看似矛盾的现象:**情境性孤独者**(State Loneliness,即因特定情境暂时感到孤独的人)倾向于寻求社交连接,因此他们更愿意接受具有自然响应(Natural Responses)、更具“人情味”的AI代理,以期获得情感慰藉;相反,**特质性孤独者**(Trait Loneliness,即长期处于孤独状态、具有社交回避倾向的人)由于害怕在真实社交中受挫,反而更偏好那些响应模式固定、可预测的“脚本化”(Scripted)AI代理,因为这种交互没有社交压力 Loneliness and Virtual Agents。这一发现为虚拟角色的个性化设计提供了深刻的心理学洞察:在追求“情感真实”的同时,也需要考虑不同用户群体的心理承受能力和社交需求。
| 关键要点观众对AI声音的评价基于自然度和相似度,对韵律的微小瑕疵极其敏感。信任分为认知信任和情感信任,AI在娱乐领域必须跨越从认知到情感的信任鸿沟。拟社会关系的建立受阻于“恐怖谷”和自主性模糊,且不同孤独特质的用户对AI的自然度偏好截然不同。 |
|---|
弥合鸿沟:人机协同与伦理护航
面对技术瓶颈与观众心理的双重挑战,纯粹依赖算法的自动化路径显然无法满足高质量内容生产的需求。在走向“情感真实”的道路上,人机协同与伦理规范成为了不可或缺的桥梁。
“人在环路”(Human-in-the-Loop, HITL):从自动化到增强智能
鉴于当前AI在情感深度和文化理解上的固有局限,**“人在环路”(Human-in-the-Loop, HITL)**模式被业界广泛认为是保证高质量输出的“安全网”和“品质防火墙”。完全自动化的纯AI方案极易产生缺乏情感共鸣、甚至存在文化冒犯的“AI垃圾”(AI Slop),这不仅会损害观众体验,更会严重侵蚀品牌信任 RWS。
在一个典型的AI辅助配音或虚拟演员工作流程中,AI与人类扮演着优势互补的角色。AI负责处理规模化、重复性的技术工作,如快速的语音转录、初步的机器翻译以及基础的语音生成。这极大地提高了生产效率。而人类专家——包括语言学家、配音导演和专业演员——则介入关键节点,负责文化调优、情感指导和最终的质量把控。他们调整AI生成的韵律,修正不自然的停顿,注入特定文化背景下的幽默或讽刺,确保最终的输出不仅在技术上准确,更在情感上能引起观众的共鸣。
这种“人机协同”并非技术不成熟时的过渡方案,而是未来内容创作的常态。它代表着一种理念的升级:从追求完全替代人类的“自动化”(Automation),转向赋能人类创作者的“增强智能”(Augmented Intelligence)。在这种模式下,AI承担了繁重的体力劳动,让人类创作者能够将精力集中在情感、创意和文化等不可替代的核心价值上。
伦理与法规的“紧箍咒”:构建负责任的AI声音生态
技术的狂飙突进必须伴随着伦理与法规的约束,否则极易引发信任危机和权利侵害。在AI声音领域,构建负责任的生态系统已成为行业共识。
首要的伦理底线是**知情同意(Informed Consent)**。声音不仅是交流的工具,更是个人生物特征和身份的重要组成部分。因此,任何对个人声音的复制、克隆和使用,都必须获得声音所有者明确、具体且可撤销的书面同意。这不仅是对个人权利的尊重,也是防止声音被滥用于欺诈或深度伪造(Deepfake)的第一道防线 RWS。
其次是**公平补偿(Fair Compensation)**机制的重塑。在AI时代,传统的按次计费(Pay-per-session)模式已无法适应声音作为“数字资产”被无限次、跨地域使用的现实。行业正在探索向基于使用范围、时长和媒介的许可/授权模式转变,确保声音演员在其数字分身的持续使用中获得公平的版税或剩余收益(Residuals)。
在法律层面,各国立法机构正快速跟进。例如,美国田纳西州在2024年通过的《ELVIS法案》(Ensuring Likeness, Voice, and Image Security Act),首次在州法层面明确将AI生成的声音克隆纳入“形象权”(Right of Publicity)的保护范围,并对未经授权的数字复制行为规定了民事和刑事处罚 Holon Law。这类立法的出台,为行业确立了清晰的法律边界。
此外,**技术保障**手段也在不断完善。为了防止AI声音被滥用,业界正在推广隐形音频水印(Audio Watermarking)等技术。这些水印对人耳不可见,但可以通过算法进行溯源和验证,从而区分真实录音与AI合成内容,为内容的真实性提供技术背书。
| 关键要点“人在环路”(HITL)是确保AI声音质量和情感共鸣的必要模式,代表着向“增强智能”的转变。知情同意和公平补偿是构建负责任AI声音生态的伦理底线。新兴立法(如《ELVIS法案》)和技术保障(如音频水印)正在为AI声音的健康发展提供制度和技术支撑。 |
|---|
总结与展望:走向“共情智能”的未来
回顾2026年AI配音与虚拟演员的发展图景,我们看到了一场技术与心理的深度博弈。在技术层面,AI语音在“形似”(音色还原、基础韵律)上已经达到了前所未有的高度,极大地提升了内容生产的效率。然而,在“神似”(真实、自发的情感表达)上,AI仍受困于“统计模仿”的本质局限,难以跨越人类语音分布的鸿沟,在复杂情感和文化语境面前显得力不从心。
在观众心理层面,接受度并非简单的技术指标可以衡量。观众对自然度的苛求、对情感信任的渴望,以及在建立拟社会关系时受到的“恐怖谷”效应和自主性模糊的困扰,都表明了人类对真实情感连接的深层需求。面对这些挑战,“人机协同”成为了当前兼顾效率与质量的最优解,而完善的伦理与法律框架则是技术健康发展的基石。
展望未来,AI语音技术的发展将不再仅仅局限于声学特征的逼真模拟,而是向着更深层次的**“共情智能”(Empathetic Intelligence)**迈进。随着多模态大模型的发展,未来的AI不仅能“听懂”文本的字面意思,还能结合视觉(面部表情)、听觉(语调变化)甚至生理信号,综合理解人类的复杂情感,并做出恰如其分、富有同理心的回应。在互动娱乐领域,我们可能会看到能够根据玩家实时情绪反馈动态调整语气和叙事策略的虚拟角色,创造出真正个性化、沉浸式的体验。
在这个过程中,人类创作者的角色不会被消解,而是会发生深刻的演变。当AI接管了声音生产的“体力劳动”后,人类的创造力、情感深度和文化洞察力将变得更加珍贵。配音演员和导演将更多地扮演“情感架构师”和“文化翻译官”的角色,引导AI在技术的框架内注入人性的温度。最终,AI配音与虚拟演员的价值,不在于它们能多完美地“伪装”成人类,而在于它们能否成为人类情感表达和文化交流的有力延伸。
参考资料
[1]
AI Voice Lab Market Size to Hit USD 50.16 Billion by 2035
https://www.precedenceresearch.com/ai-voice-lab-market
[2]
AI Voice Cloning in Real-Time: A Deep Learning Approach
https://smallest.ai/blog/real-time-ai-voice-cloning-deep-learning-tts-clone
[3]
How is prosody controlled in modern TTS systems?
https://milvus.io/ai-quick-reference/how-is-prosody-controlled-in-modern-tts-systems
[4]
From compliance deadlines to dubbing at scale, localization drives ...
[5]
Insights on the Perception of AI-Voice Clones from ...
https://www.isca-archive.org/interspeech_2025/bakkouche25_interspeech.pdf
[6]
Finding the Human Voice in AI: Insights on the Perception ...
[7]
How do consumers perceive virtual agents with behavioral realism ...
https://pmc.ncbi.nlm.nih.gov/articles/PMC12980403/
[8]
Insights on the Perception of AI-Voice Clones from ...
https://www.isca-archive.org/interspeech_2025/bakkouche25_interspeech.pdf
[9]
Entertainment & Multimedia Localization: AI Dubbing and Subtitling ...
https://awprotranslations.com/entertainment-multimedia-localization-ai/
[10]
Synthetic Media & Voice Cloning: Right of Publicity Risks ...
[11]
"The Voice Actor and Their Double" by Adam Paul
https://oasis.library.unlv.edu/tradition_innovations/vol1/iss1/6/
[12]
AI dubbing in 2026: the complete guide for global business ... - RWS
https://www.rws.com/blog/ai-dubbing-in-2026/
[13]
Fostering Parasocial Relationships with Virtual Influencers in the ...
https://www.sciencedirect.com/science/article/abs/pii/S0148296324005289
[14]
Voice AI Trends 2026: Enterprise Adoption & ROI Guide
https://nextlevel.ai/voice-ai-trends-enterprise-adoption-roi/
[15]
Voice Cloning: Comprehensive Survey
https://arxiv.org/html/2505.00579v1
[16]
Influence of parasocial relationship between digital ...
https://www.sciencedirect.com/science/article/abs/pii/S0747563218302553
[17]
On the Emotion Understanding of Synthesized Speech
https://arxiv.org/html/2603.16483
[18]
AI Agents Are About To Change Gaming Forever
https://www.forbes.com/sites/bernardmarr/2026/02/11/ai-agents-are-about-to-change-gaming-forever/
[19]
The Ultimate Voice Agents-Related Statistics (2026)
https://jestycrm.com/blog/voice-agents-related-statistics
[20]
How Do Consumers Trust and Accept AI Agents? An Extended ...
https://pmc.ncbi.nlm.nih.gov/articles/PMC11939248/
[21]
Emotional Prosody Control for Speech Generation
https://www.isca-archive.org/interspeech_2021/sivaprasad21_interspeech.pdf
[22]
LLM-driven fine-grained emotion parsing and ...
https://www.sciencedirect.com/science/article/abs/pii/S0031320326005108